OpenAI APIの12時間プロンプトキャッシュとは?料金・設定方法と定期処理への使い方
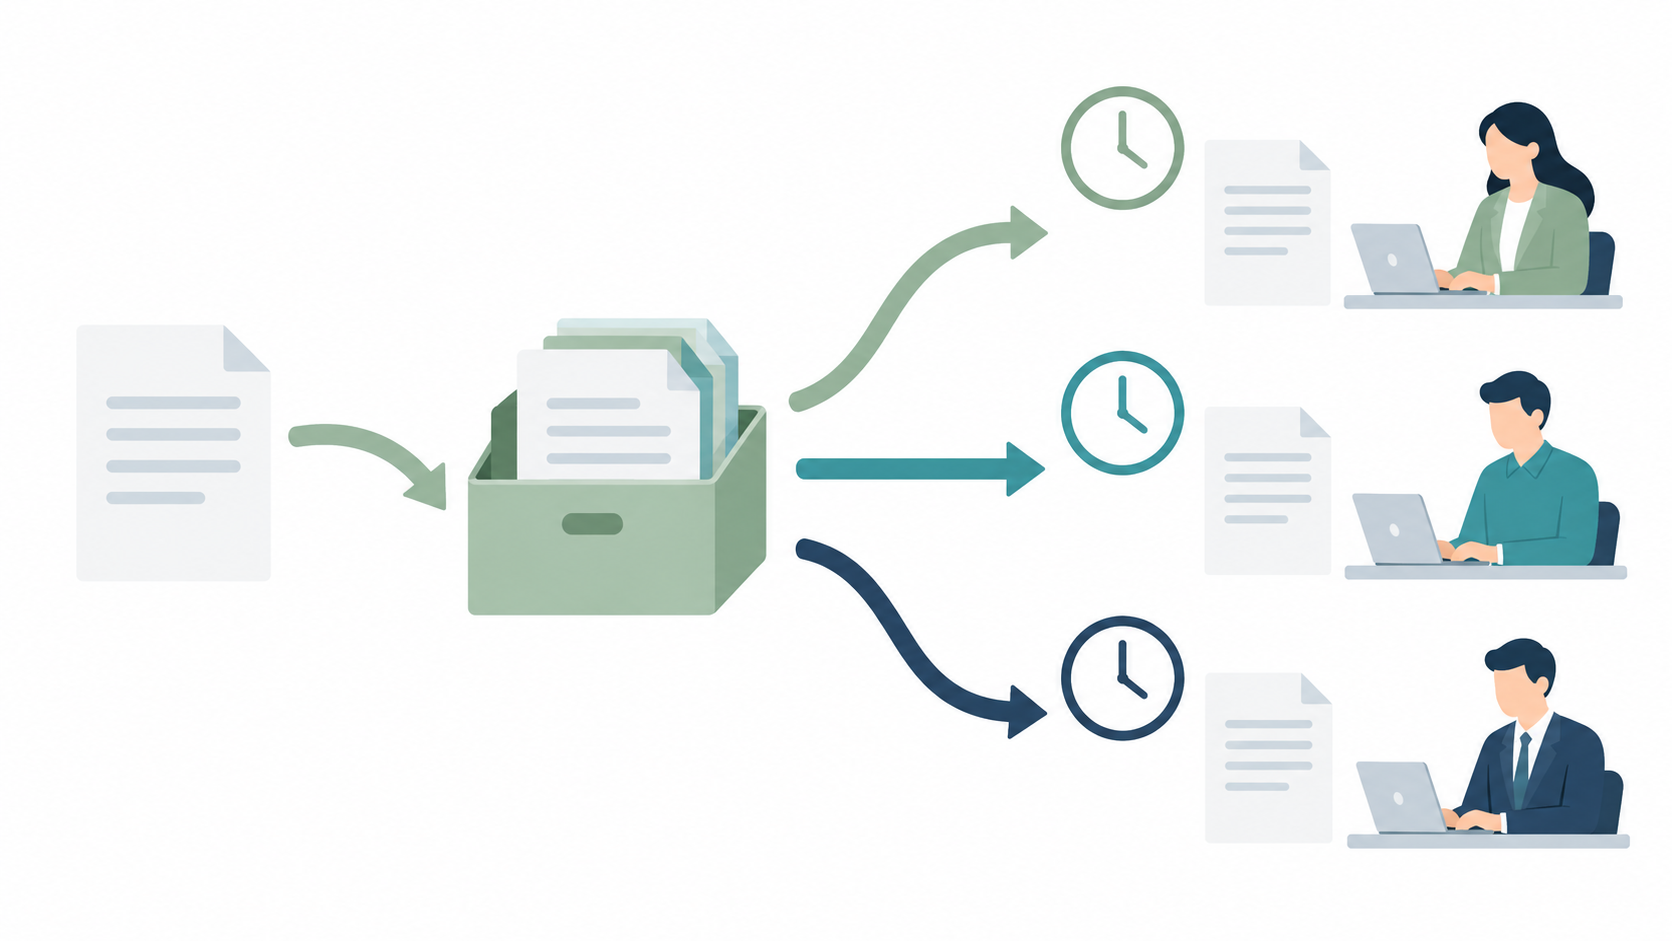
AIエージェントに毎回同じ業務ルール、ツール定義、社内資料を渡しながら、案件ごとの入力だけを差し替える処理では、同じ前提を何度も読み込むコストが積み重なります。たとえば午前・午後に分けてレポートを作る、数時間おきに問い合わせを分類する、定期実行のたびに同じ運用手順を適用する、といった仕事です。
OpenAIは2026年10月20日、Responses APIでプロンプトキャッシュの最低保持時間を12時間にできる機能を公開しました。利用間隔が30分を超える処理でも、共通する入力の先頭部分を数時間後に再利用しやすくなります。ただし、キャッシュ書き込みは通常入力の2.5倍で、実際のヒットも保証されません。料金と入力の組み方を見て、使いどころを決める必要があります。
結論:12時間プロンプトキャッシュは、GPT-5.6以降の対応モデルをResponses APIから使うとき、同じプロンプトの先頭部分を最低12時間キャッシュ対象にする設定です。会話全文を保存して次回の入力を省く機能ではありません。初回書き込みが通常入力の2.5倍になるため、長く変わらない指示やツール、共有資料を十分な回数再利用できる定期処理で、キャッシュ読み取り料金と比べて判断します。
本記事のポイント
- 12時間キャッシュはResponses APIで共通プレフィックスの最低保持時間を12時間にする設定で、会話全文を保存・再利用する機能ではありません。
- GPT-5.6以降では12時間の書き込みが通常入力の2.5倍、読み取りは多くのモデルで0.1倍、GPT-6.1 Solでは0.05倍の単価です。
- 有利かは安定プレフィックスの長さと再利用回数次第です。GPT-6.1 Solの例では、同じ1万トークンを3回以上使うと入力料金が未キャッシュより下がります。
12時間キャッシュで再利用するのは、会話ではなく入力の共通部分
プロンプトキャッシュは、モデルが入力を処理したときにできるキー・バリュー状態を使い、後続リクエストに同じ先頭部分があれば、その処理を再利用する仕組みです。対象になるのは「同じ依頼の回答」ではなく、システムや開発者の指示、ツール定義、会話履歴、共有資料など、リクエスト内で前から一致している入力です。後続の依頼や回答を先回りして保存するわけではなく、キャッシュされた入力を読んだうえでモデルは毎回新しい回答を生成します。
そのため、アプリケーションが次のリクエストに必要な会話履歴や作業状態を引き続き送る設計は変わりません。12時間キャッシュを有効にしても、サーバー側に「この利用者との会話」が自動で作られたり、以前の出力が会話メモリとして呼び戻されたりするわけではありません。会話の保管や再開には、Responses APIのprevious_response_idやConversations APIの会話状態機能など、別の仕組みが必要です。各方式と保存条件はOpenAI公式のConversation stateガイドで確認できます。
ヒットには、同じモデルと処理設定で、キャッシュ対象の入力が同じ順序・内容・境界で届くことが重要です。先頭の指示に日付や案件固有データを混ぜる、ツールの定義や順序を変える、同じメッセージを書き換える、といった差分があると、変化した位置より後ろの再利用範囲が短くなります。キャッシュの保管場所も個々のマシンであり、組織やリージョンをまたいで共有されません。長い履歴の圧縮や不要なツール出力が精度に与える影響は、AIエージェントのコンテキストロットの対策と合わせて考えると整理しやすくなります。
12時間は、入力全文を12時間固定で保存するという意味でもありません。OpenAIの説明では、GPT-5.6以降で指定する「最低保持時間」であり、12時間より長く保持される場合もあります。一方、キャッシュの一致や利用マシンへのルーティングは保証されず、最低保持時間を指定しても必ずヒットするとは限りません。この設定を会話履歴の削除時刻やデータ保存期間の指定として扱わないでください。
設定対象はResponses APIの対応モデル、再利用する境界を先に決める
12時間の指定は、2026年10月20日のOpenAI API更新としてResponses APIに追加されました。現在のPrompt cachingガイドでは、GPT-5.6以降について、リクエストのprompt_cache_options.ttlに30mまたは12hを指定できます。Chat Completionsなど旧モデル向けのprompt_cache_retentionとは別の設定なので、既存コードのパラメーター名を置き換える前に、エンドポイントとモデルの対応を確認してください。最新モデルのAPI料金と使い分けはGPT-6 Sol・LunaのAPI料金とモデル選定も参考になります。
短い間隔で使う会話やエージェント手順なら既定の30分から始め、数時間空いても変わらない共有指示・資料を使うときだけ12時間を検討します。長く残す部分と短時間だけ再利用したい部分が混在する場合、Responses APIではブレークポイントごとに保持時間を分けられます。次の例では、開発者メッセージ内の共有部分を12時間対象にし、依頼ごとに変わるユーザー入力はキャッシュ書き込み境界の後ろに置いています。
const response = await client.responses.create({
          model: "gpt-6.1-sol",
          prompt_cache_options: { mode: "explicit", ttl: "30m" },
          input: [
            {
              role: "developer",
              content: [{
                type: "input_text",
                text: "共通の業務ルール、出力形式、安定したツール定義",
                prompt_cache_breakpoint: { mode: "explicit", ttl: "12h" }
              }]
            },
            {
              role: "user",
              content: [{
                type: "input_text",
                text: "今回の案件情報と、今回だけの依頼"
              }]
            }
          ]
        });
mode: "explicit"では、開発者が指定したブレークポイントだけを使います。共通指示をinput_textとして置き、変更する依頼・顧客データはその後ろに分けます。modeを指定せず暗黙キャッシュを使う方法もありますが、どこまでを長く保持するか制御したい業務では、共通部分の終端を明示する方が料金を読みやすくなります。OpenAI提供の非表示システム文は最小長の対象に含まず、GPT-5.6以降ではキャッシュ可能な先頭部分に1,024個以上の可視入力トークンが必要です。短い指示を無理に増やすのではなく、実務上必要な安定資料があるかを確かめます。
また、GPT-5.6以降のprompt_cache_keyはヒット率を上げるために必須ではありません。顧客やワークスペースごとにキャッシュ利用量を分けて請求・監査したい場合に、安定したキーを分けて使う用途があります。キーを付けてもキャッシュ命中や特定マシンへの固定は保証されません。設定可能なモデル、ブレークポイントの作り方、利用量の読み方はOpenAI公式のPrompt cachingガイドで確認できます。
料金は初回書き込みと、後続の読み取りを別々に計算する
12時間キャッシュの書き込み単価は、通常入力の2.5倍です。これは通常入力料金に2.5倍分を追加する意味ではなく、キャッシュ対象トークンを「12時間書き込み」の単価で数えるという意味です。キャッシュ読み取り単価は保持時間によって上がらず、通常入力より大幅に低い設定です。モデル別の通常入力・出力・キャッシュ済み入力・書き込み単価は変わるため、採用するモデルの料金表を基準にしてください。
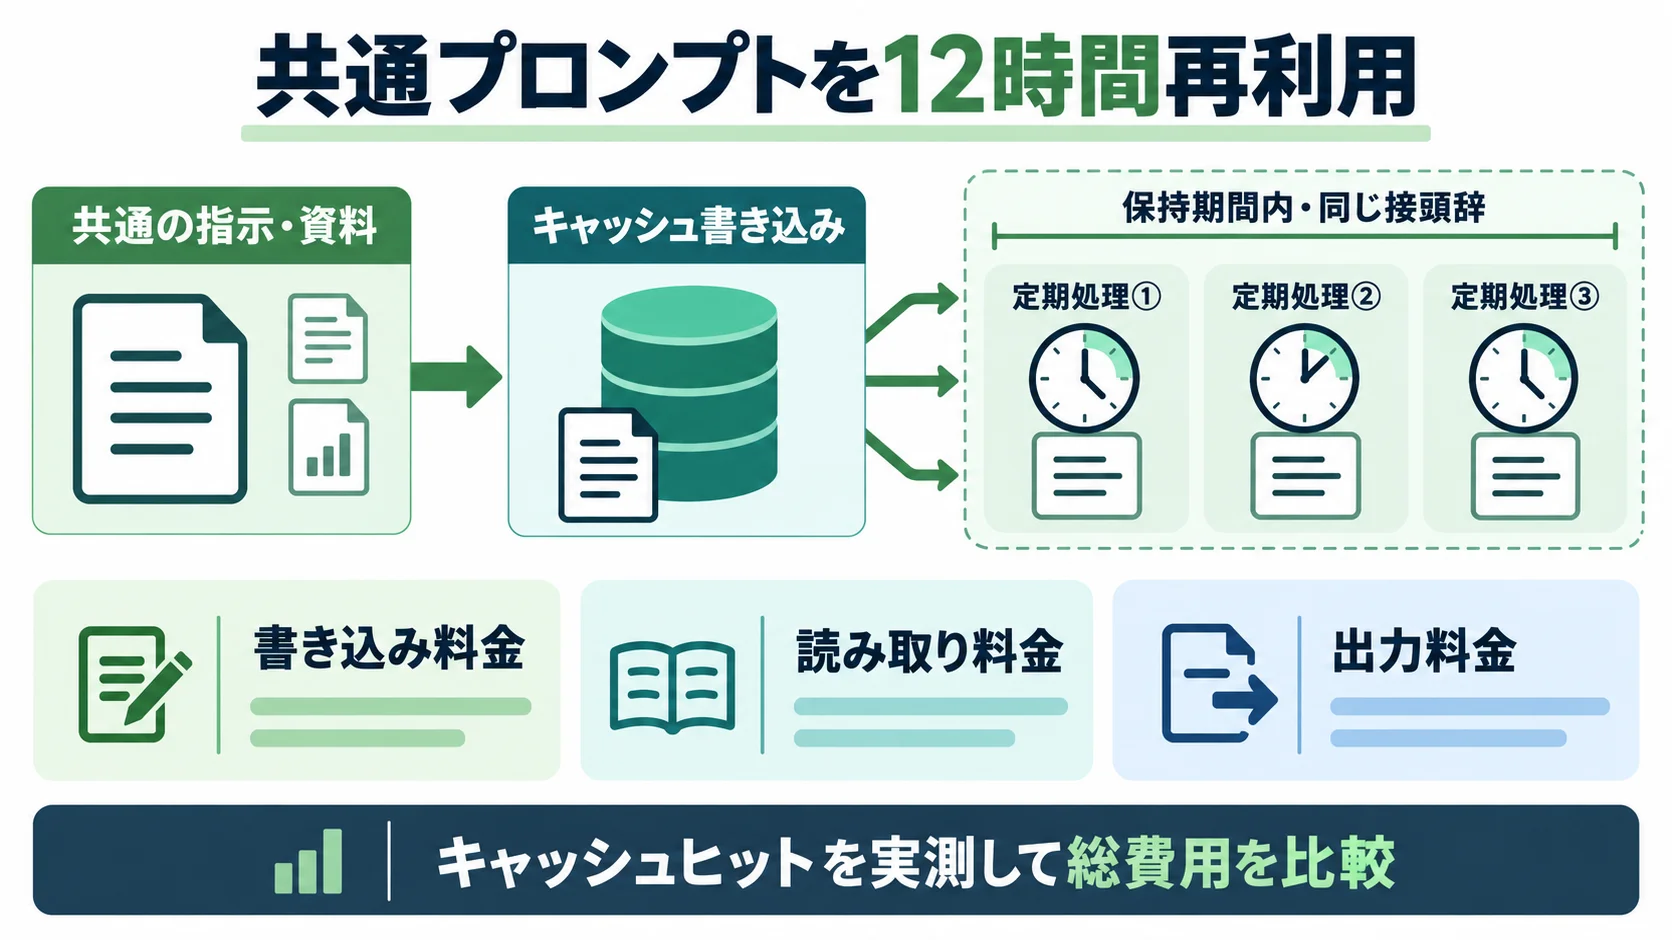
比較しやすいように、2026年10月21日時点のStandard料金でGPT-6.1 Solを例にします。入力は100万トークンあたり2ドル、キャッシュ済み入力は0.10ドル、30分書き込みは2.50ドル、12時間書き込みは5ドル、出力は10ドルです。つまり、同じ1万トークンの共通入力でも、未キャッシュの読み込みは0.02ドル、12時間の初回書き込みは0.05ドル、その後のキャッシュ読み取りは0.001ドルになります。単価はOpenAI公式のAPI料金表に基づきます。
| GPT-6.1 Sol Standardの入力料金 | 100万トークンあたり | 1万トークンあたり |
|---|---|---|
| 通常入力 | $2.00 | $0.020 |
| 30分キャッシュ書き込み | $2.50 | $0.025 |
| 12時間キャッシュ書き込み | $5.00 | $0.050 |
| キャッシュ読み取り | $0.10 | $0.001 |
仮に、共通する1万トークンを含む同じ仕事を、開始時・3時間後・6時間後・9時間後・11時間後の計5回処理し、2回目以降はすべてキャッシュ読み取りになるとします。この条件なら、12時間キャッシュの共通入力部分は、書き込み0.05ドル+読み取り0.001ドル×4回=0.054ドルです。同じ部分を毎回通常入力で送る場合は0.02ドル×5回=0.10ドルです。仕事ごとに変わる入力と、同じ条件なら発生する出力料金は両方式で共通なので、この比較には含めていません。
この例は12時間内にキャッシュが利用可能で、同一プレフィックスが毎回一致するという試算です。現実のキャッシュヒットは保証されません。また、同じ5回でも、30分キャッシュが各利用前に失効し、毎回書き込みになる条件なら、1万トークンあたり0.025ドル×5回=0.125ドルとなり、キャッシュなしの0.10ドルを上回ります。30分の最低保持時間を超えても実際にはキャッシュが残る場合があるため、これは上限予測ではなく、各回で書き込みが起きた場合の比較です。
GPT-6.1 Solで12時間キャッシュを毎回ヒットさせる単純モデルなら、同じプレフィックスを合計3回使う時点で入力料金が下がります。1回目の0.05ドルに、後続2回分の0.001ドルを加えた0.052ドルに対し、未キャッシュなら0.06ドルです。2回しか使わないと12時間キャッシュは0.051ドル、未キャッシュは0.04ドルなので割高です。この分岐はモデル価格、再利用回数、実測ヒット率が変われば変わります。さらに出力量はキャッシュの割引対象ではなく、モデルが回答を生成するたびに通常の出力料金がかかります。
数時間おきの定期処理は、利用間隔と実測ヒット率で選ぶ
12時間キャッシュをまず検討しやすいのは、日中に複数回動くものの、呼び出し間隔は30分を超える定型業務です。たとえば毎朝の規定チェック、数時間おきの問い合わせ振り分け、定期レポート作成などで、共通の指示・回答形式・ツール定義・共有資料を繰り返し使う構成です。ここでは一日の途中で変わらない内容を先頭に集め、当日の実データ・対象顧客・個別タスクを後ろへ分けます。対象業務やAIエージェントの選定から整理するなら、営業AIエージェントの業務と選定軸も参照できます。
設定前後を比べるときは、利用日ごとに以下を記録します。
- 入力したモデル、API、リージョン、保持時間、プロンプトの版
- 共通プレフィックスのおおよそのトークン数と、処理の実行時刻・間隔
- Responses APIの使用量に返る
cached_tokens、cache_write_tokens、可能なら30分・12時間別の書き込みトークン数 - 通常入力・キャッシュ読み取り・キャッシュ書き込み・出力を分けた費用と、処理の品質・完了率
まず数日分の利用量から、12時間の初回書き込み後に何回再利用できたかを出します。次にプロンプトやツール定義を変えた日を分け、キャッシュが外れた場合の書き込み費用も数えます。OpenAIのPrompt Cachingダッシュボードでは、キャッシュヒット率や読み取り対書き込みの比率を追跡できます。見積もりでは将来のヒット率を保証せず、未キャッシュ入力が続いたケースも予算に含めてください。安定ブロックを短くする、変動情報を後方へ移す、実行タイミングを調整する余地があるかも合わせて確認します。
保持時間はデータ運用の判断とも関係します。OpenAIのデータ管理ガイドでは、プロンプトキャッシュが暗号化されたキー・バリュー状態をGPUローカルにアプリケーション状態として保存する場合があり、最大24時間の保持制限があると説明しています。12時間の指定は最低保持時間であって、12時間後の削除期限ではありません。また、in_memoryと24hの両方に対応する旧世代モデルでは、Zero Data Retention(ZDR)が有効な組織の既定値がin_memoryになる旨が記載されています。GPT-5.6以降のttlはこの最大保持方針を変える設定ではないため、厳格な保存要件があるときは、OpenAIのデータ管理ガイドと組織に適用されている設定を確認してください。リージョンを分けて処理する場合も、キャッシュは地域境界を越えて再利用できず、地域処理に対応しない場所で拡張キャッシュを使うと、リージョン外の処理・一時保存が必要になる場合があります。
結局、12時間キャッシュを選ぶ基準は、毎回同じ部分の長さ、同じキャッシュを使う回数、処理間隔、データ保持要件の4点です。1日に1回だけの処理や、入力内容が毎回変わる仕事では、2.5倍の書き込み費用を取り戻せないことがあります。反対に、十分長い固定指示と共有ツールを、30分より長い間隔で何度も使うなら、12時間は再書き込みを減らす候補です。小さく計測し、出力品質と請求額の両方で続けるか決めます。
よくある質問
Q. 12時間キャッシュは会話全体を保存しますか?
いいえ。プロンプトの一致した先頭部分に対する計算状態を再利用します。会話履歴が入力の一部なら、その履歴も同じプレフィックスの範囲でキャッシュされる可能性はありますが、次回リクエストに必要な履歴や新しい依頼をアプリケーションから送る設計は別に必要です。
Q. 数時間後のリクエストは必ずキャッシュヒットしますか?
いいえ。12時間は最低保持時間で、同じ入力・モデル・処理設定が一致することや、利用するマシンでキャッシュが使用可能なことも関係します。利用量のcached_tokensとcache_write_tokensを見て、想定した先頭部分が本当に読み取られたか確認します。
Q. 4時間おきに使えば、読み取りのたびに12時間が延長されますか?
いいえ。12時間の保持は書き込み時点からの最低時間で、読み取りは12時間の時計を再スタートしません。OpenAIのガイドでは、読み取りが最低30分の保持を更新し、既存の12時間有効期間があればその期限を保つと説明しています。最初の書き込みから12時間を超える継続利用は、新たな書き込みが必要になる可能性を見込んでください。
Q. 12時間後にキャッシュは必ず削除されますか?
いいえ。ttl: "12h"は最低保持時間の指定であり、削除時刻ではありません。OpenAIのデータ管理ガイドは、キャッシュ状態が最大24時間保持される場合があると説明しています。保持要件が厳しい場合、12時間TTLだけで削除を保証しないでください。
共通指示と都度変わる業務データの分け方、運用指標、AIエージェントを使った定期業務の設計を整理したい場合は、AI活用・業務自動化の導入支援を見るから、対象業務と小規模検証の進め方を確認できます。
