AI評価の採点基準を校正する方法|LLM-as-a-judgeと人手評価のずれを減らす手順
LLM-as-a-judgeやルールベースの自動採点が人手評価とずれるとき、採点モデルを先に交換するより、何を合格と呼ぶかを人がそろえ、採点例と判定結果を照合することが先です。評価対象の回答を同じルーブリックで人が読み、意見が割れたケースを裁定し、その独立したラベルと自動採点を比較します。平均点だけを追うと、重大な失敗を見逃したり、文章が長い回答を過大評価したりするためです。
この記事の手順は、採点器そのものを校正するためのものです。対象モデルやプロンプトを改善する回帰テストとは目的が異なります。OpenAIの評価ガイドも、人手の判断で自動採点を校正し、pairwise比較やpass/failを使い、回答の提示順や長さによる偏りを確かめる考え方を示しています。評価基準が変わったら、同じデータを再採点した結果を新旧の版として残してください。
採点基準の校正は、代表的なサンプルを校正用と独立したholdout用に分け、2人以上の人手評価を裁定付きで確定し、そのラベルと自動採点の混同行列・分母を確認してから合格基準を決めます。具体的には、評価項目を観察可能な行動に分解し、良い例・境界例・失敗例をルーブリックへ置きます。採点器の提示順を交換し、短い回答と長い回答を同じ内容で比較し、モデル・採点プロンプト・評価データの版を固定したうえで、変更後にholdoutを一度だけ判定します。
本記事のポイント
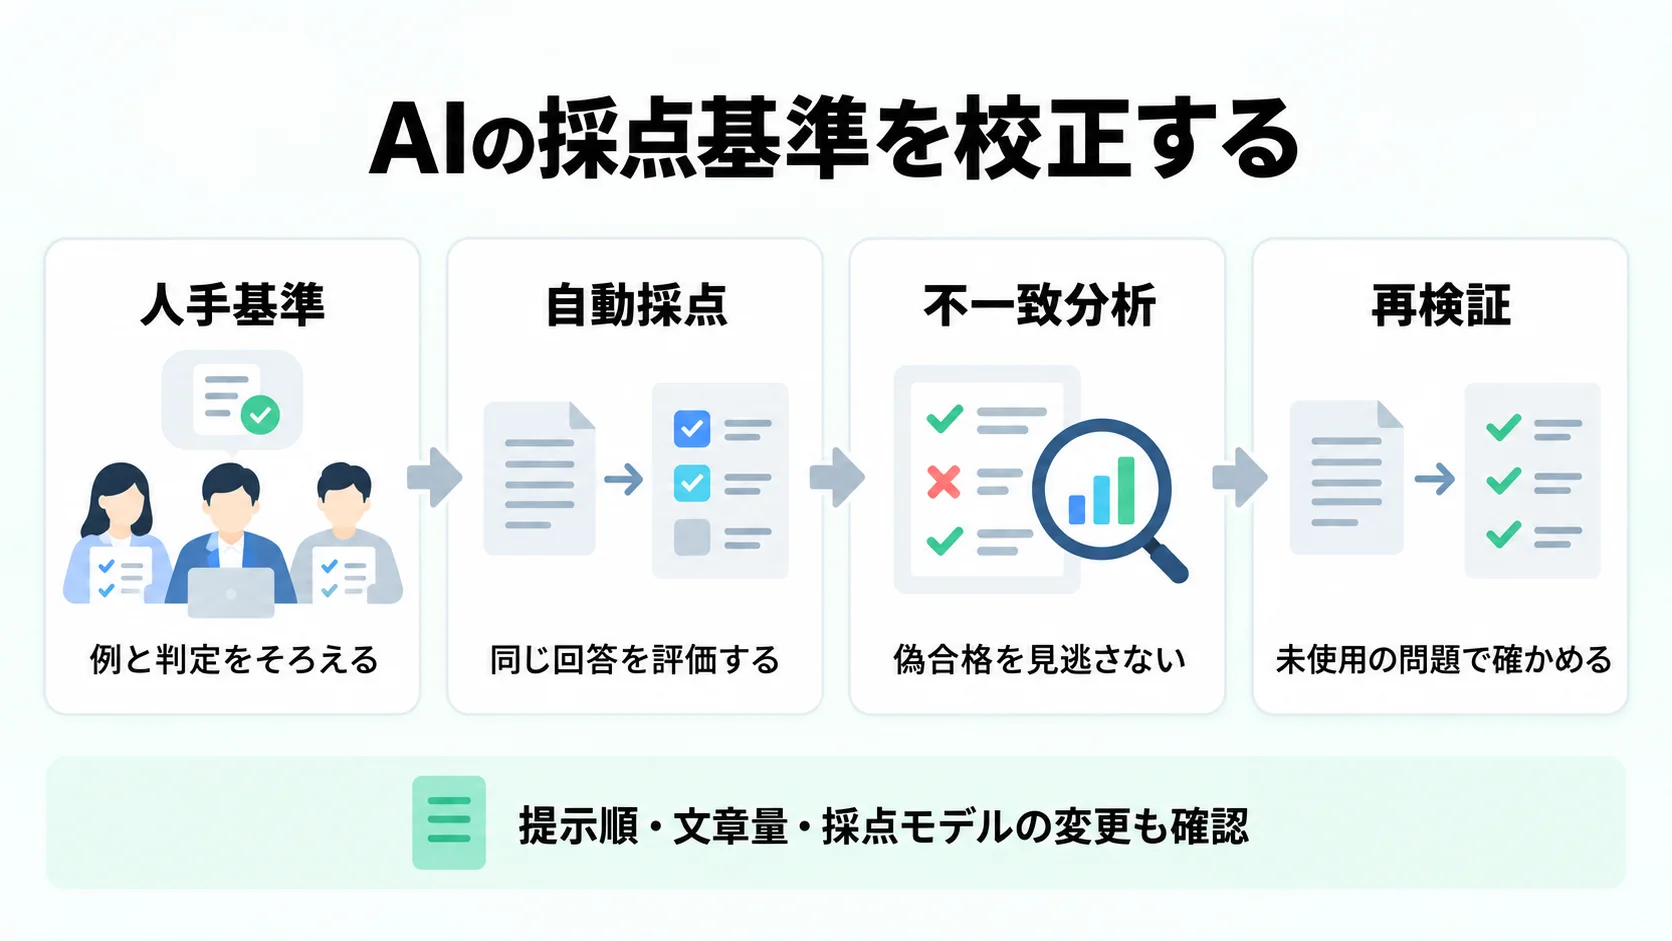
- 自動採点を信頼する前に、人手の基準を具体例でそろえ、意見が割れた回答は理由を記録して裁定します。
- 校正に使った回答と合否を最後に確認するholdoutを分け、偽合格・偽不合格を分母付きで比較します。
- 提示順・文章量・採点モデルやプロンプトの版を固定し、変更後は独立データで再検証します。
1. まず「良い回答」と合格条件を観察可能な言葉にする
採点の校正で最初に決めるのは、採点モデルの名前ではなく、回答のどの性質を合格とみなすかです。「自然でよい」「役に立ちそう」といった印象語だけでは、同じ回答を読んでも人によって結論が変わります。たとえば社内規程を答えるAIなら、事実が根拠資料と一致していること、質問に直接答えていること、分からない場合に断定しないこと、許可されていない操作を勧めないことを別項目にします。
1つの総合点へ急いでまとめず、評価項目を分解してから重みを決めます。次のような表を最初のルーブリックとして使えます。
| 項目 | 合格の観察条件 | 不合格の例 | 重大度 |
|---|---|---|---|
| 正確性 | 根拠資料にある事実・数値・条件を取り違えない | 根拠にない数値を事実として追加する | 高 |
| 関連性 | 質問の要求を外さず、必要な範囲で答える | 周辺知識を長く述べ、依頼された判断を残す | 中 |
| 安全な不確実性 | 根拠が不足すると確認先や不明点を示す | 推測を断定し、利用者の判断を誤らせる | 高 |
| 形式・実行可能性 | 指定形式を守り、次に取る行動が読み取れる | JSON指定を崩す、または実行不能な手順を出す | 中 |
各項目には、完全に満たす例、境界にある例、明らかに満たさない例を用意します。OpenAIの評価ガイドは、スコアの異なる例を「見せて説明する」ことを勧めています。実務では、たとえば「正確性が高いが回答形式を外した例」「流暢だが根拠のない断定をした例」を用意すると、採点者が文章の印象へ引っ張られにくくなります。例示は採点者の学習材料であり、公式の合格点や普遍的な閾値ではありません。
二値のpass/failだけでなく、部分点を許す設計が適する場合もあります。たとえば、必須条件をすべて満たすと1、軽微な形式不備だけなら0.5、重大な誤りがあれば0とする方法です。ただし、この数値はこの記事の説明用の例です。実際の閾値は、誤答の業務影響、許容できる確認コスト、利用者が負うリスクを踏まえて決め、数値の由来を記録してください。重大項目を平均で相殺しないよう、「高重大度の不合格が1件でもあれば全体は不合格」のようなゲートを別に設けることもあります。
対象がAIエージェントなら、最終文面だけでなく、ツール選択・引数・権限・停止条件も評価対象にします。AIエージェント ガバナンスとは?権限、監査ログ、承認フローの設計を整理するで扱われるような業務フローでは、回答が丁寧でも誤った顧客情報を更新した時点で重大な失敗になり得ます。採点表に「回答の品質」と「外部作用の安全性」を別の列で持たせると、文章のうまさが危険な操作を相殺する事態を防げます。
2. 校正用サンプルで人手評価をそろえ、不一致を裁定する
次に、実際の利用分布を反映したサンプルを作ります。通常ケースだけでなく、短い質問、複数の依頼を含む質問、表記揺れ、根拠が欠ける質問、権限外の依頼、過去に事故になったケースを含めます。OpenAIの評価ガイドも、典型例・境界例・敵対的な例を含め、運用ログや専門家が作ったデータを組み合わせる考え方を示しています。生成した合成データだけに寄せず、実際の失敗を個人情報や機密情報を除いた形で再現してください。
サンプルを校正用、検証用、holdout用に分けます。校正用はルーブリックの文言、例示、重み、採点プロンプトを調整するために使います。検証用は調整の途中で傾向を確認するためのデータです。holdoutは、採点器と人手基準が固まるまで結果を見ず、最終検証に使います。非決定性を測る必要がある場合は、holdoutに対する実行回数と集計法を結果を見る前に決めておきます。holdoutの結果を見てルーブリックや採点器を調整した場合、そのデータはもう独立していないため、新しいholdoutを確保し直します。これは呼び名ではなく、誰がいつ結果を見たかで判定します。
人手評価は可能なら2人以上が独立して行います。最初から相談しながら1つのラベルを作ると、採点者同士の不一致が見えません。各人は回答の内容、根拠、ルーブリックの該当項目、重大度、判定理由を記録します。作業者には、モデル名や実験の優劣、回答を生成した順序を知らせないほうが、期待による偏りを抑えやすくなります。
判定が割れた回答は、単純な多数決だけで終わらせません。まず、どのルーブリック項目で割れたかを分類します。事実の解釈が違うのか、重大度の境界が曖昧なのか、根拠資料の版が違うのかを分けます。次に、基準例へ戻って、採点者が指摘した文を引用しながら裁定します。裁定者は結論だけでなく、「この条件なら合格」「この条件なら不合格」というルールの修正案を残します。裁定でルーブリックが変わったら、変更前に採点した校正用サンプルを新しい基準で再採点し、ラベルの版を更新します。
不一致率が下がったことだけを合格の証拠にしないでください。全員が曖昧な基準を同じ方向に誤っている可能性があります。高重大度の境界例、根拠が不足する例、意図的に長く書かれた例を定期的に差し戻し、裁定の理由が再現できるか確認します。業務に複数の専門領域があるときは、1人の専門家を全分野の唯一の正解にせず、分野ごとの裁定者と根拠資料の責任者を決めます。
OpenAIの別の評価資料で説明されるgraderは、参照回答とモデル出力を比較し、0から1の範囲で部分点を返す考え方や、文字列照合・類似度・モデル評価・Python評価を組み合わせる考え方を紹介しています。ただし、ここで重要なのは特定のAPIを採用することではなく、採点器が何を入力にし、どの根拠で、どんな尺度を返すかを明示することです。人手ラベルとの一致を確認しないまま、自動採点の数値だけを品質の証拠にしないでください。
人手評価の運用を営業AIへ広げるときは、営業AIを本番投入する前のAgent Evalsで扱われる業務シナリオの観点も参考になります。この記事では評価対象の改善ではなく、採点基準の一致と裁定記録に集中します。
3. 混同行列と分母で、偽合格・偽不合格を見分ける
人手による最終ラベルを基準とし、自動採点のpass/failを比較すると、4種類の結果に分かれます。人手も合格、自動も合格なら真陽性、人手は不合格なのに自動が合格なら偽陽性(偽合格)、人手は合格なのに自動が不合格なら偽陰性(偽不合格)、両方が不合格なら真陰性です。呼び方はチームで固定し、対象が「合格」を陽性とすることを表に書いてください。
| 人手:合格 | 人手:不合格 | 行の分母 | |
|---|---|---|---|
| 自動:合格 | 真陽性 | 偽陽性(偽合格) | 自動合格数 |
| 自動:不合格 | 偽陰性(偽不合格) | 真陰性 | 自動不合格数 |
| 列の分母 | 人手合格数 | 人手不合格数 | 全サンプル数 |
数字を報告するときは、率だけでなく分子と分母を併記します。たとえば、説明用に「100件のholdoutで、人手合格が60件、そのうち自動合格が54件、人手不合格が40件、そのうち自動合格が4件だった」とします。この場合、偽合格率を「4 / 40 = 10%」と報告するのか、自動合格に占める偽合格を「4 / 58 ≒ 6.9%」と報告するのかで意味が変わります。前者は人手不合格をどれだけ見逃したか、後者は自動合格の中にどれだけ誤りが混ざったかを示します。どちらも必要なら、率の名前と分母を明示します。この数字は説明用の仮例であり、公式の閾値や推奨値ではありません。
同じように、偽不合格を「人手合格のうち自動が不合格だった割合」と報告すると、利用可能な回答を落としている程度が分かります。正確性の項目だけで集計せず、重大度、データの種類、言語、質問の長さ、権限の有無などの層別に分けます。全体の平均が良くても、少数の重大ケースで偽合格が集中していれば、リリース判定へ使う採点器としては危険です。
総合スコアや一致率は、基準の一部を要約する指標です。人手ラベルが二値なら一致率を出せますが、クラス比率が偏っていると、常に多数派を選ぶだけでも高く見えます。合格が大半のデータで不合格を一度も見ない採点器は、見た目の一致率が高くても役に立ちません。少数の重大失敗を意図的に含め、層ごとの分母を残し、全体率だけで合否を決めないでください。
連続スコアを使う場合は、どの点からpassとするかを校正用データで決めます。候補の閾値を複数並べ、偽合格と偽不合格が業務上どの程度発生するかを比較します。閾値を少し動かしただけで結果が大きく変わるなら、回答の境界を追加し、ルーブリックの判定基準を細かくします。holdoutで都合のよい閾値を探すのは、独立評価を失うため避けます。
学習やプロンプト調整に使った回答を合否判定にも使うと、採点器が見慣れた表現へ過剰適合します。AI評価データの漏えい防止と開発用・合否判定用データの分離で扱うように、校正データへのアクセスを記録し、holdoutの閲覧権限を絞ります。評価結果を見て改善するほど、独立した合否判定データの価値は高くなります。
4. 提示順・文章量・版を固定して、変更後に再検証する
LLMを採点者に使うと、内容以外の要素が判定を動かすことがあります。2つの回答を比べるpairwise評価では、同じ回答IDの組み合わせを、回答ID A→Bの順とB→Aの順で提示した結果を別に取り、勝者が同じ回答IDになるかを見ます。A/Bという表示記号の勝者を比べるのではなく、元の回答IDへ戻して判定を比較することがポイントです。勝者の回答IDが入れ替わることが多い場合、ルーブリックの差が曖昧なのか、先に見た回答を好む位置バイアスなのかを分けるため、人手裁定へ戻します。
文章量の影響も、同じ意味を短く答えた回答と、冗長に答えた回答で確認します。長い回答には正しい説明も誤った説明も増えるため、「情報が多いから高得点」とは限りません。短い回答が必要なタスクで要件を満たしているなら、長さそのものを評価項目にしない設計を検討します。反対に、根拠の列挙が必須なら、必要な根拠が揃っているかを観察可能な条件として書き、文字数で代用しません。
採点器を比較するときは、モデル、採点プロンプト、システム指示、temperatureなどの生成設定、データセットとその分割、参照回答、ルーブリック、コード、結果の取得日時を一つの試験記録へ固定します。モデルだけを変えたつもりで、同時に採点プロンプトや入力順が変わると、差の原因を判断できません。採点結果には各版の識別子を付け、同じ入力を何回実行したかも残します。
変更後の再検証は、次の順序で行います。非決定性を含む評価では、同じ条件で何回実行するか、平均・中央値・分位点などをどう集計するかを、結果を見る前に決めます。
- 変更理由と変更範囲を記録し、モデル・採点プロンプト・ルーブリック・データ版を固定する。
- 校正用データで、新旧の採点器を同じ回答へ適用し、不一致がどの項目で増減したかを確認する。
- 提示順を交換したpairwiseケースと、短文・長文の対照ケースを実行する。
- 変更を見ていないholdoutを、事前に定めた回数と集計法で最終検証し、混同行列と層別の分母を記録する。
- 重大な偽合格がないかを人が再確認し、採用・保留・差し戻しを決める。
採点器の一致率が上がったのに、特定の業務カテゴリで偽合格が増えたなら、全体の改善と判断しません。人手ラベルの不一致、データ分布の変化、参照回答の古さ、評価対象の仕様変更を別々に調べます。変更が落ち着いた後も、実運用から新しい失敗ケースを追加し、定期的に人手との一致を監視します。評価は一度の認定ではなく、モデルや業務条件の変化を検知する継続的な仕組みです。
採点基準の変更履歴を、評価対象システムのリリース履歴と混ぜないことも大切です。対象システムが変わったのか、採点器が変わったのか、同じ回答を再評価しただけなのかを記録上区別します。回帰テスト全体の設計はAIプロンプトの回帰テスト設計が扱う領域ですが、そこで使う合否判定器も、ここで説明した校正・holdout・混同行列の確認を経てから採用します。
よくある質問
人手評価は何人いれば十分ですか?
一律の人数を公式閾値として決められるものではありません。少なくとも複数人が独立して同じサンプルを評価し、不一致を観察できる状態にします。専門性が必要な項目は、該当領域を判断できる担当者を含め、サンプル数、採点者、裁定者、評価期間を記録してください。人数を増やすだけで基準が明確になるわけではないため、境界例と裁定理由の再現性も確認します。
人手評価の一致率が低いとき、採点モデルを変えるべきですか?
先にルーブリックと基準例を点検します。不一致が正確性・重大度・不確実性などのどの項目で起きたかを分類し、根拠資料の版と評価条件をそろえます。基準を裁定しても人手同士の判断が安定しない領域は、無理に自動化せず、人の確認を必須にする選択もあります。
合格率が高ければ、採点器は校正できていますか?
高い合格率だけでは判断できません。人手の合否を基準に、偽合格と偽不合格を分け、各率の分母を示します。重大な不合格を自動で合格にしていないか、少数カテゴリに誤りが集中していないか、holdoutで確認してください。この記事の数値例は説明用であり、公式の合格閾値ではありません。
pairwise評価は単独回答の採点より優れていますか?
LLMが比較や分類をしやすい場合があるため、有力な方法の一つです。ただし、提示順や文章量のバイアスが入り得ます。同じ2回答の順序を交換し、勝者が安定するかを確認し、人手の裁定ラベルと照合します。絶対評価が必要な業務では、単独回答のルーブリック評価や必須条件の検査も併用します。
OpenAIのEvalsやGraders APIを新しい実装の前提にできますか?
現時点の公式deprecations情報では、Evalsは2026年10月31日に既存の評価がread-onlyとなり、2026年11月30日にダッシュボードとAPIが終了予定です。Evalsのワークフローで文書化されたGradersもこの移行の対象です。したがって、この記事は採点基準の校正方法を扱い、特定のAPIの継続提供や新規実装を推奨しません。採用中のサービスを使う場合も、データ・ルーブリック・人手ラベルを持ち出せる形で保存し、移行先で同じholdoutを再検証できるようにします。
AIエージェントの評価運用について相談先を探している方は、ファネルAiのAI活用支援の案内をご覧ください。現在の評価データや失敗例を整理し、社内で採点基準と再検証の条件を話し合う材料にできます。超速AIパートナーの案内を見る
公式情報と適用範囲
評価設計、人手評価による自動採点の校正、pairwise比較、提示順・文章量の偏り、継続評価についてはOpenAIのEvaluation best practices、採点器の種類と部分点の考え方についてはGradersの公式ガイドを参照しました。EvalsとGradersの提供時期に関する注意は公式Deprecationsを基準にしています。いずれも2026年9月28日時点の公開情報として扱い、記事中の数値例は説明用に作成したものです。
