AI評価データの漏えい防止|開発用と合否判定用を分ける権限と版管理
生成AIアプリやAIエージェントの改善では、プロンプトや検索設定を何度も直してテストします。このとき、合否判定に使うテスト質問を開発者が見て、その質問に合わせてプロンプトを直すと、テストの点は上がっても初めて見る質問には答えられなくなります。機械学習で「データ漏えい」と呼ばれる問題で、AIアプリでは開発者自身が漏えいの経路になりやすいのが特徴です。評価項目の決め方はAgent Evalsの評価項目と運用手順、採点のずれの直し方はAI評価の採点基準を校正する方法で扱っています。
先に結論:AIの改善効果を正しく測るには、プロンプト調整に使う「開発用データ」、案の比較に使う「検証用データ」、リリースの合否だけに使う「合否判定用データ」を分け、合否判定用は開発者が中身を見られない権限にします。言い換えた同じ質問が混ざっていないかを類似度で点検し、評価データに版番号を付けて「どの版で合格したか」を残すと、テストの点だけ高く本番で外れる状態を防げます。
本記事のポイント
- 開発用・検証用・合否判定用の3つにデータを分け、合否判定用は開発者が中身を見られない権限にして、結果は合否と点数の増減だけを返します。
- 完全一致だけでなく言い換えや同じ資料から作った質問の混入を類似度とグループ単位の分割で点検し、追加や入れ替えのたびに確認します。
- 合否判定用データに版番号とハッシュ値を付け、どの版で合格したかをリリース記録に残し、決めた時期に一部を入れ替えます。
1. なぜAI評価データの漏えいが起きるのか
プロンプトやモデルの評価において、データ漏えいが起きる経路は単純なコピー&ペーストだけではありません。開発者が日常のデバッグや精度改善を行う中で、意図せず評価セットの情報がプロンプトやロジックへ染み出すパターンが複数存在します。
機械学習の古典的なデータ漏えいに対し、LLMアプリケーションでは「プロンプトエンジニア自身」が媒介となって漏えいを引き起こします。合否判定用のテストで失敗したケースを開発者が直接見て、「この質問にはこう答えよ」とプロンプトに追記したり、その質問と正解のペアをFew-shot事例として登録したりすることで、テスト問題の答えをカンニングさせた状態を作ってしまうのです。
| 漏えいのパターン | 具体的な発生要因 | 本番で発生するリスク |
|---|---|---|
| 直接的な事例混入 | テストデータから失敗事例を抜き出し、プロンプトのFew-shot事例にそのまま追加する | そのテストケースのみ正解率が100%になり、似た未知の質問で汎化できない |
| 指示文の過剰個別化 | テストに含まれる固有名詞や特殊な文脈に対応する条件分岐プロンプトを個別追加する | プロンプトが長大化して指示追従性が落ち、通常の対話品質が劣化する |
| 意味的重複(近傍データ) | 文言は異なるが、意図・エンティティ・前提条件が同一の質問が両方のセットに存在する | 開発セットで調整した結果がテストセットにそのまま反映され、過大評価される |
| 反復試行による統計的漏えい | 合否判定セットに対して1日に何十回も実行し、スコアが上がるプロンプトだけを残す | テストケースそのものを見ていなくても、スコア増減を通じてテストセットへ過剰適合する |
Scikit-learn公式ドキュメントの「Common pitfalls and recommended practices」では、前処理やモデル選定を含むすべての意思決定をテストデータから隔離しなければ、検証結果の信頼性は損なわれると明確に警告されています。生成AIにおいても、テストセットは「未知の質問に対してどれだけ正しく振る舞えるか」を判定する唯一の監査壁であり、この壁が侵食されると社内テストの成功が本番の失敗を隠蔽することになります。
2. データセットの3層分離モデル:開発・検証・合否判定
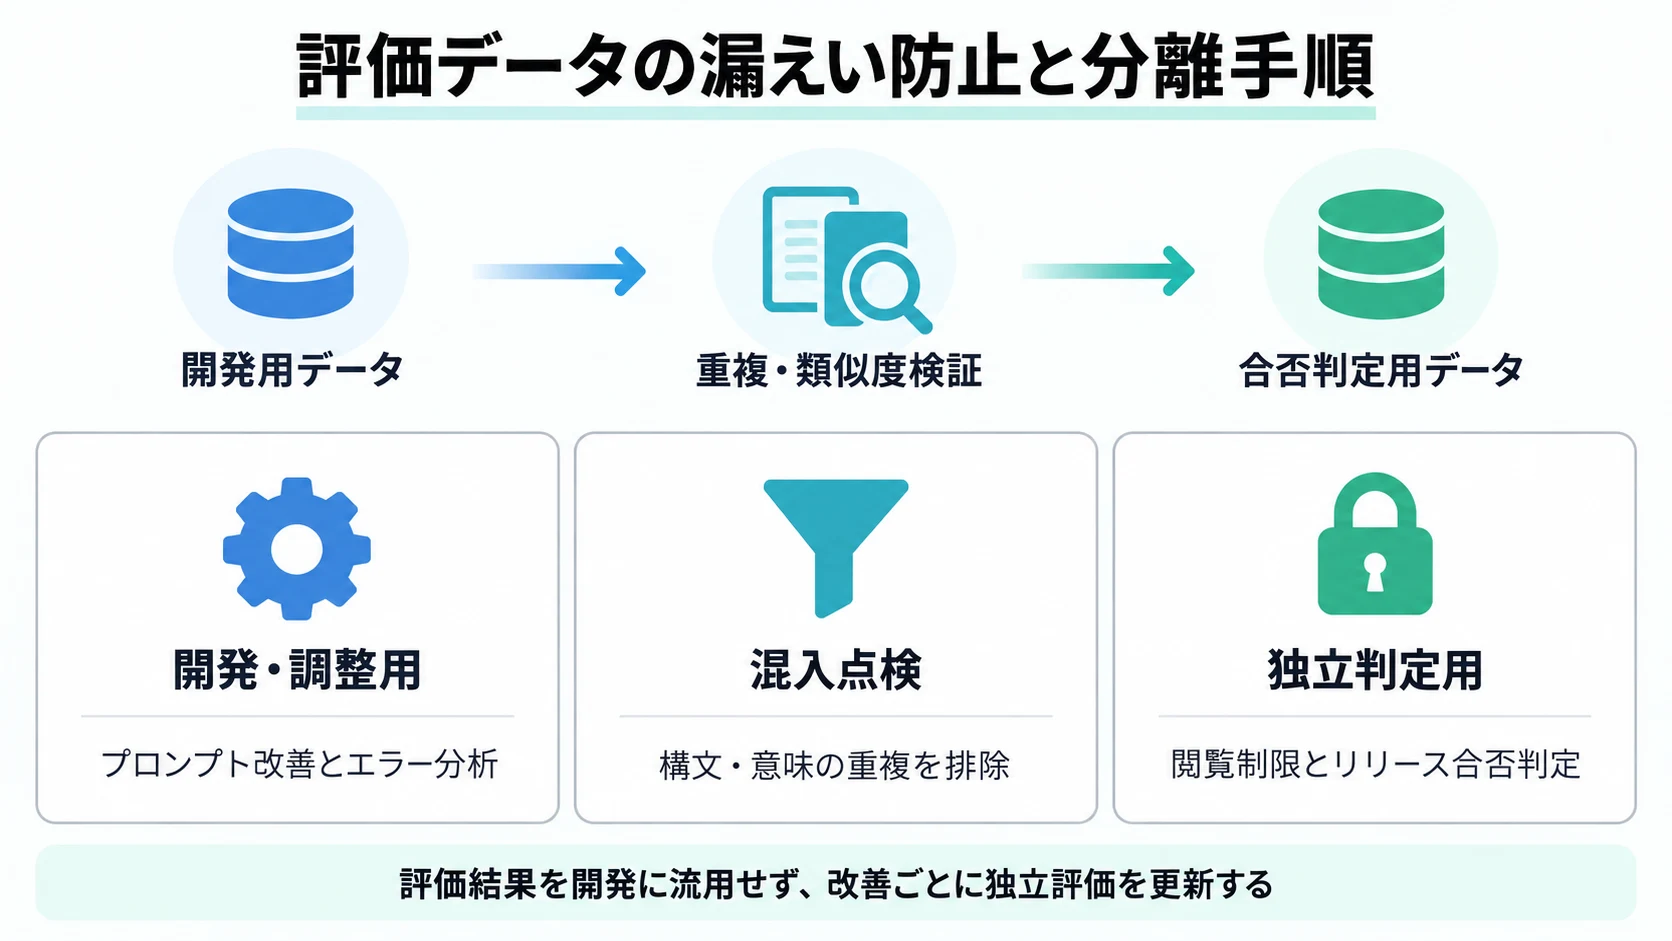
データ漏えいを防止するための最初の実務手順は、評価データを目的別に明確な3層に分離することです。単に「テストデータ」と一括りにせず、誰が、どの段階で、どのような権限でアクセスできるかを定義します。
- 開発用セット(Development Set):開発者が日常のプロンプト作成、Few-shotの試作、エラー分析、対話ログの確認に自由に使えるデータです。失敗ケースの全文を閲覧し、原因調査のためにいくらでもデバッグして構いません。
- 検証・パラメータ探索セット(Validation Set):プロンプトの複数候補(A案・B案)の比較や、検索のTop-K件数、Rerankerのスコア閾値など、システムパラメータのハイパーパラメータ探索に使うデータです。自動スクリプトで一括実行し、統計的な比較を行います。
- 合否判定用セット(Holdout Test Set):本番環境へのデプロイ可否、リリースゲートの通過判定にのみ使用する最高機密のデータです。開発者は個別の質問文や正解ラベルを直接閲覧できず、CI/CDパイプラインによる自動実行のみが許可されます。
実務では、3層の権限・重複検知・版管理を次の1つの表で決めておきます。自社の状態をこの表に当てはめると、どこが漏えいの経路になっているかを一度に点検できます。特に合否判定用データへのアクセス権限を厳格化することが最も効果的です。
| 項目 | 開発用データ | 検証用データ | 合否判定用データ |
|---|---|---|---|
| 使う目的 | プロンプト作成、失敗原因の分析、Few-shot候補の選定 | プロンプト案の比較、検索件数や閾値の調整 | リリース可否の判定、品質低下の検知だけ |
| 閲覧できる人 | 開発者全員(中身を見て編集してよい) | 開発者は結果の集計だけ見る(個別の質問は必要時のみ) | 評価パイプライン用のサービスアカウントだけ。開発者は中身を見られない |
| 開発者へ返す結果 | 入出力の全文 | カテゴリ別の正解率、所要時間、費用 | 合否と、カテゴリ別の点数の増減だけ(失敗した質問文は返さない) |
| 重複検知 | 合否判定用との重複を確認してから追加する | 合否判定用との重複を確認する | 追加・入れ替えのたびに、他の2つと完全一致・正規化一致・意味の近さを確認する |
| 分け方の単位 | 同じマニュアル・同じ製品・同じ問い合わせ元から作った質問は、ランダムに散らさず同じ層にまとめる | ||
| 版管理 | 自由に更新してよい | 比較の途中で変えない(変えたら比較をやり直す) | 版番号とファイルのハッシュ値を記録し、どの版で合格したかをリリース記録に残す。上書きせず新しい版として追加する |
| 更新の時期 | 随時 | 比較の区切りごと | 決めた時期に一部を入れ替え、退役させたデータは開発用へ移す |
合否判定用セットの結果を開発者にフィードバックする際、失敗した質問文をそのままレポートに載せてはいけません。「どの質問で失敗したか」が分かれば、開発者は無意識にその質問を修正対象にしてしまうからです。開発者に返す情報は「カテゴリAの正確性が前週より下がった」「JSONの形式エラーが発生した」といった集約結果に留め、具体的な入力テキストは伏せる「ブラインド評価(Blind Evaluation)」を徹底します。
より高度な監査や組織的な第三者検証を行う場合の枠組みについては、AI第三者評価の評価設計でも整理されています。自社の開発チーム自身が評価を実施する場合であっても、第三者評価と同様の「開発者と評価データの独立性」を担保することが不可欠です。
3. 類似度・言い換えによる漏えいを検知・排除する手順
データを開発用と合否判定用に分けたとしても、元データが同一の問い合わせ履歴やFAQからサンプリングされている場合、「文言が少し違うだけで同じ事象を質問しているペア」が両方のセットに散らばってしまう危険があります。これを「意味的漏えい(Semantic Contamination)」と呼びます。
例えば、「パスワードを忘れた場合の再発行手順を教えてください」が開発用セットにあり、「ログインパスワードのリセット方法はどうすればいいですか?」が合否判定セットにある場合、文字列の完全一致比較では重複として検知できません。しかしモデルにとっては実質的に同じ問題であり、真の汎化性能を測るテストにはなりません。この意味的漏えいを検知・排除するためには、多層的な重複チェックパイプラインを構築します。
- 完全一致・正規化一致の排除:スペース、改行、大文字小文字、全角半角、句読点を正規化したハッシュ値(SHA-256)を比較し、完全一致する重複を即座に排除します。
- 埋め込みベクトルによるコサイン類似度検知:高性能なテキスト埋め込みモデルを用いて質問文をベクトル化し、開発用セットと合否判定用セットの全ペア間でコサイン類似度を算出します。類似度の高い順にペアを並べ、上位から人が確認して、どこから重複と判断するかの閾値を自社データで決め、その閾値を超えるペアを「漏えい候補」としてフラグ付けします。
- エンティティおよび業務グループ単位の分割(Group Split):同一の取扱説明書、特定の製品カテゴリ、特定の障害インシデントに関する問い合わせ群は、ランダムに分割せず、エンティティやトピックのグループ単位で丸ごと開発用または合否判定用に割り振ります。これにより、同一コンテキストからの情報漏えいを根本から防ぎます。
- 人間によるサンプリング監査:フラグが立った高類似度ペアを、開発チームとは別の品質保証担当者が目視で確認し、意図や前提が完全に重複している場合は合否判定セットから除外または別シナリオへの差し替えを行います。
| 検証手法 | 検知できる漏えい | 推奨される閾値・基準 | 運用上の注意点 |
|---|---|---|---|
| ハッシュ完全一致 | 同一テキストの単純重複、コピーミス | ハッシュ一致(100%一致) | 表記揺れや句読点一つの違いで見逃すため第1段階に過ぎない |
| 埋め込みコサイン類似度 | 言い換え表現、類義語置換、質問順序の逆転 | 自社データで重複と判断したペアの類似度を確認して決めた閾値 | 埋め込みモデル自体の性能に依存するため、適切なモデルを選定する |
| トピック/グループ分割 | 同一マニュアル・同一顧客に起因する文脈漏えい | カテゴリID・文書ID単位で100%完全分離 | ランダムサンプリング(Stratified Split)を盲信しない |
| LLM-as-a-Judge判定 | 文構造が全く異なるが前提条件・要求が同一のケース | プロンプトによる「同一意図」判定フラグ | 計算コストがかかるため、高類似度候補の絞り込み後に適用する |
埋め込みモデル自体のバージョン変更やインデックス再構築を伴う場合は、埋め込みモデルの移行手順で解説しているインデックス切り替えの管理手法と連携させ、類似度計算の基準が意図せずブレないよう注意します。
4. 評価セットの版管理とアクセスガバナンス
合否判定用データセットは、ソースコードと同様にバージョン管理システムで厳格に管理されなければなりません。データがいつの間にか追加されたり、不都合なテストケースがこっそり削除されたりする状態では、過去のリリースとの精度比較(回帰分析)が不可能になります。
評価データセットには、必ずセマンティックバージョニング(例:eval-dataset-v2.1.0)を付与し、データセット自体のチェックサム(SHA-256)をコミットメタデータとして固定します。これにより、「どのモデルリリースが、どの評価データセットのバージョンに対して合否判定をパスしたのか」を将来にわたって完全に追跡可能にします。
NISTのAIリスク管理フレームワーク(AI RMF 1.0)は、評価に使ったテストセットや指標、ツールの詳細を文書化すること(MEASURE 2.1)と、展開するAIシステムが妥当で信頼できることを示し、開発時の条件を超えた一般化の限界を文書化すること(MEASURE 2.5)を求めています。評価データに版番号とハッシュ値を付けて残すことは、この「どのテストで確かめたか」を後から示すための実務的な方法です。テストデータを共有ドライブにエクセルファイルで放置するような管理から脱却し、CI環境からのみアクセス可能なデータパイプラインへ統合することがガバナンスの第一歩です。
5. 評価データが「摩耗」したときの更新と補充サイクル
どんなに厳重に分離された合否判定セットであっても、同じテストセットに対して何度もプロンプト修正や評価を繰り返していると、テストセットは徐々に「摩耗(Wear-out)」していきます。これは多重仮説検定の問題として知られており、無数のプロンプト試行錯誤の中から「たまたまその合否判定セットで高得点が出たプロンプト」が選ばれやすくなるためです。
評価セットの摩耗を防ぎ、常に本番環境の未知データに対する実力を正確に測定するためには、定期的なデータセットのローテーション(入れ替え)と補充サイクルを計画的に回す必要があります。
- 本番対話ログからの定期サンプリング:本番環境でユーザーから実際に寄せられた対話ログのうち、低評価がついたものやエスカレーションされた事例、新しい業務パターンの質問を定期的に収集します。
- 個人情報・機密情報のマスキング(サニタイズ):実対話ログには顧客名、個人名、機密情報が含まれるため、専用の自動マスキングツールと目視確認を通じて安全なテスト用テキストに変換します。
- 既存テストセットとの類似度検査:新しく作成した候補データが、既存の開発用セットや合否判定用セットと重複していないかを前述の類似度パイプラインで確認します。
- 合否判定セットへの段階的ローテーション:使い古された合否判定セットの一部を、あらかじめ決めた時期に退役させ、開発用セットへと「格下げ」して開発者の自由な分析に開放します。そして、新しく収集・サニタイズした未知のデータを新しい合否判定セットとして組み込みます。
- ベースラインの再測定:テストセットが更新されたら、現在本番稼働中のプロンプトやモデルを用いて新テストセットでのベースラインスコアを測定し直します。旧テストセットのスコアと新テストセットのスコアを単純比較して一喜一憂せず、新しい基準値を起点として以降の改善効果を追跡します。
| フェーズ | 実施頻度 | 主な作業内容 | 成果物 |
|---|---|---|---|
| 対話ログ収集・マスキング | 定期的に | 本番ログからエッジケースを抽出し、個人情報・機密情報を匿名化 | サニタイズ済み候補データ |
| 重複排除とグループ分類 | 候補データを追加するたび | 既存の開発用セットとの埋め込み類似度を計算し、重複のないケースを選別 | 独立確認済み候補プール |
| データセットローテーション | あらかじめ決めた時期 | 古い合否判定データの一部を開発用へ格下げし、新データを合否判定へ投入 | 新バージョンのデータセット(vN+1) |
| 新ベースライン設定 | ローテーション直後 | 現行の本番プロンプト・モデルで新セットを実行し、新基準値を確定 | ベースラインベンチマーク報告書 |
モデル自体のサポート終了やメジャーアップデートに伴ってシステム全体を見直す場合は、AIモデル廃止・提供終了への変更管理で述べているように、モデル切り替えの判定基準と評価データセットの版を連動させて管理することが重要です。
よくある質問
開発用データと合否判定用データは、何件ずつ用意すべきですか?
決まった件数はありません。合否判定用は、1問の正誤で全体の点数が大きく動かない件数を確保します。例えば100問なら1問で1ポイント動くため、改善幅がそれより小さい場合は判定できません。開発用は、失敗のパターンを一通り見られる件数から始めます。
同じ質問の言い換えによるデータ混入をどう点検しますか?
文字列の完全一致だけでなく、テキスト埋め込みモデルを用いたベクトル類似度計算を実施します。開発用セットと合否判定用セットの全組み合わせでコサイン類似度を算出し、類似度の高い順にペアを並べ、上位から人が確認して、どこから重複と判断するかの閾値を自社データで決めます。また、質問文を生成した元資料やトピックID単位でデータを分割することで、構造的な重複を防止します。
評価セットの閲覧権限と版をどう管理しますか?
合否判定用データセットはGit等のバージョン管理システムや暗号化されたオブジェクトストレージに保存し、コミットごとのSHA-256ハッシュで完全性を保証します。開発者個人のIAMアカウントからはファイルの中身を読めないようにアクセス権限(RBAC)を設定し、CI/CDパイプラインのサービスアカウントのみが評価スクリプト実行時にメモリ上に読み込めるように制御します。
評価結果を見て改善した場合はいつ新しい独立評価を用意しますか?
合否判定セットを用いたリリース判定を繰り返し、プロンプトの調整が頭打ちになってきた場合や、あらかじめ決めた見直しの時期を迎えたタイミングで、合否判定用データの一部を新しい実運用ログから採取したデータへ入れ替えます。役目を終えた古い合否判定データは開発用セットへ移管し、以後の詳細なエラー分析用として活用します。
プロンプトのFew-shotに合否判定データの失敗例を追加してはいけないのはなぜですか?
合否判定データに含まれる質問と正解をFew-shotに追加すると、モデルはその特定の質問パターンを丸暗記してしまい、テストスコアだけが人工的に満点近くまで跳ね上がります。しかし未知の表現や前提が異なる実ユーザーの質問に対しては全く対応できず、本番環境で深刻な品質トラブルを引き起こす原因になります。Few-shotには必ず開発用データの中から選定した汎用的な代表例を使用してください。
外部の評価SaaSやLLM-as-a-Judgeを使う際もデータ分離は必要ですか?
必要です。外部の評価ツールやLLM-as-a-Judgeを用いる場合でも、評価基準として投入するゴールデンデータセットが開発者のプロンプトチューニング環境と混ざっていれば、同様のデータ漏えいが発生します。外部SaaSを利用する場合も、プロジェクトやワークスペースを「開発用」と「リリース判定用」で厳密にアカウント分離して運用することが推奨されます。
社内AIや生成AIエージェントの精度向上を進める中で、評価スコアと本番での体感精度の乖離にお悩みの場合は、開発用データと合否判定用データの分離設計や、意味的重複を排除するパイプラインの構築が有効です。自社業務に合わせた評価体制の構築をご検討の際は、現在の運用状況を添えてお気軽にお問い合わせください。
参考情報
- scikit-learn: Common pitfalls and recommended practices(Data leakage)
- NIST AI RMF 1.0 Core(MEASURE 2.1・2.5)
- NIST AI 100-1: Artificial Intelligence Risk Management Framework (AI RMF 1.0)
- OpenAI: Evaluation best practices
2026年10月26日時点の公開情報に基づきます。
