埋め込みモデルの移行手順|再生成・検索評価・インデックス切替を揃える方法
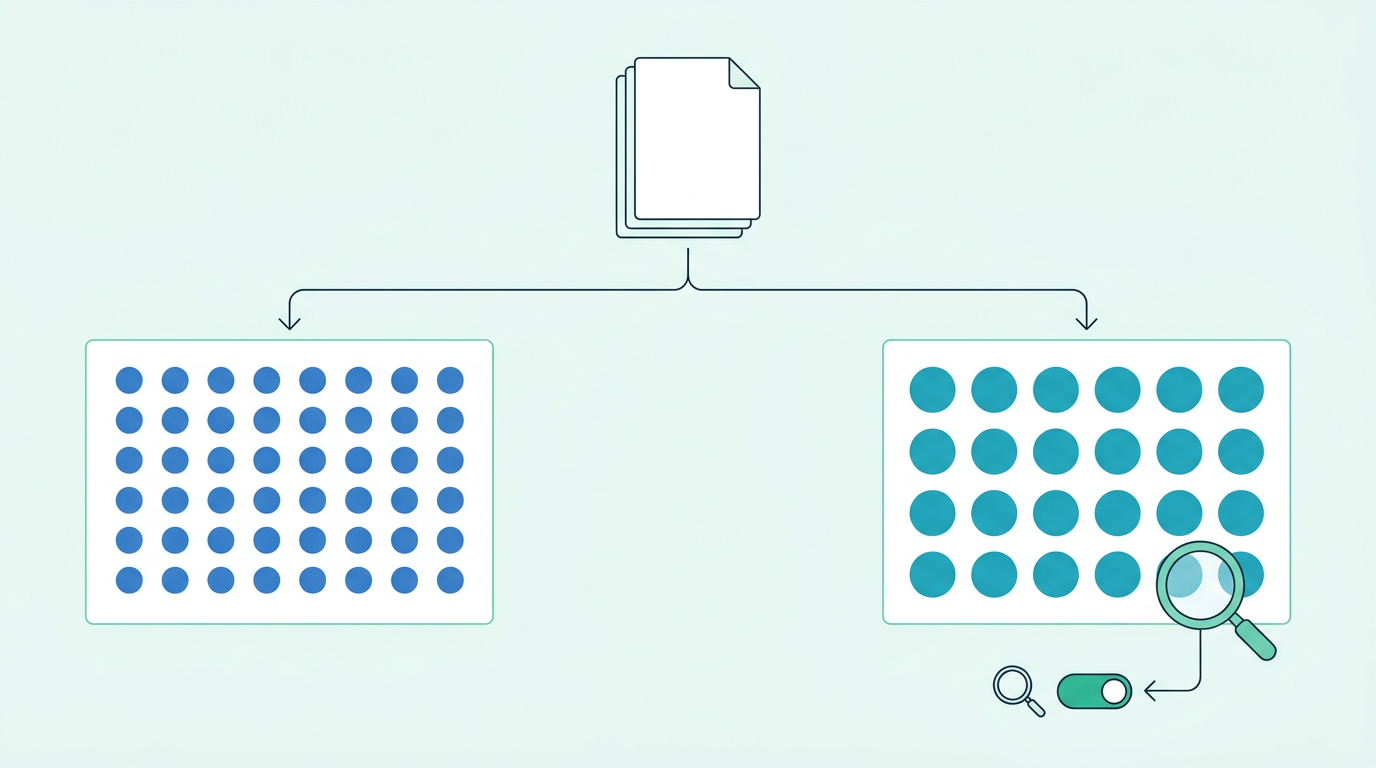
埋め込みモデルを変更するときに、APIのモデル名だけを差し替えて検索を再開するのは危険です。埋め込みは文章や画像などを数値ベクトルへ変換するため、モデル、バージョン、入力の分割方法、出力次元、正規化、距離尺度が検索結果の意味を決めます。文書を旧モデルで登録したまま質問だけを新モデルに変えると、新旧のベクトル空間を比較することになり、類似度の順位を正しく解釈できません。
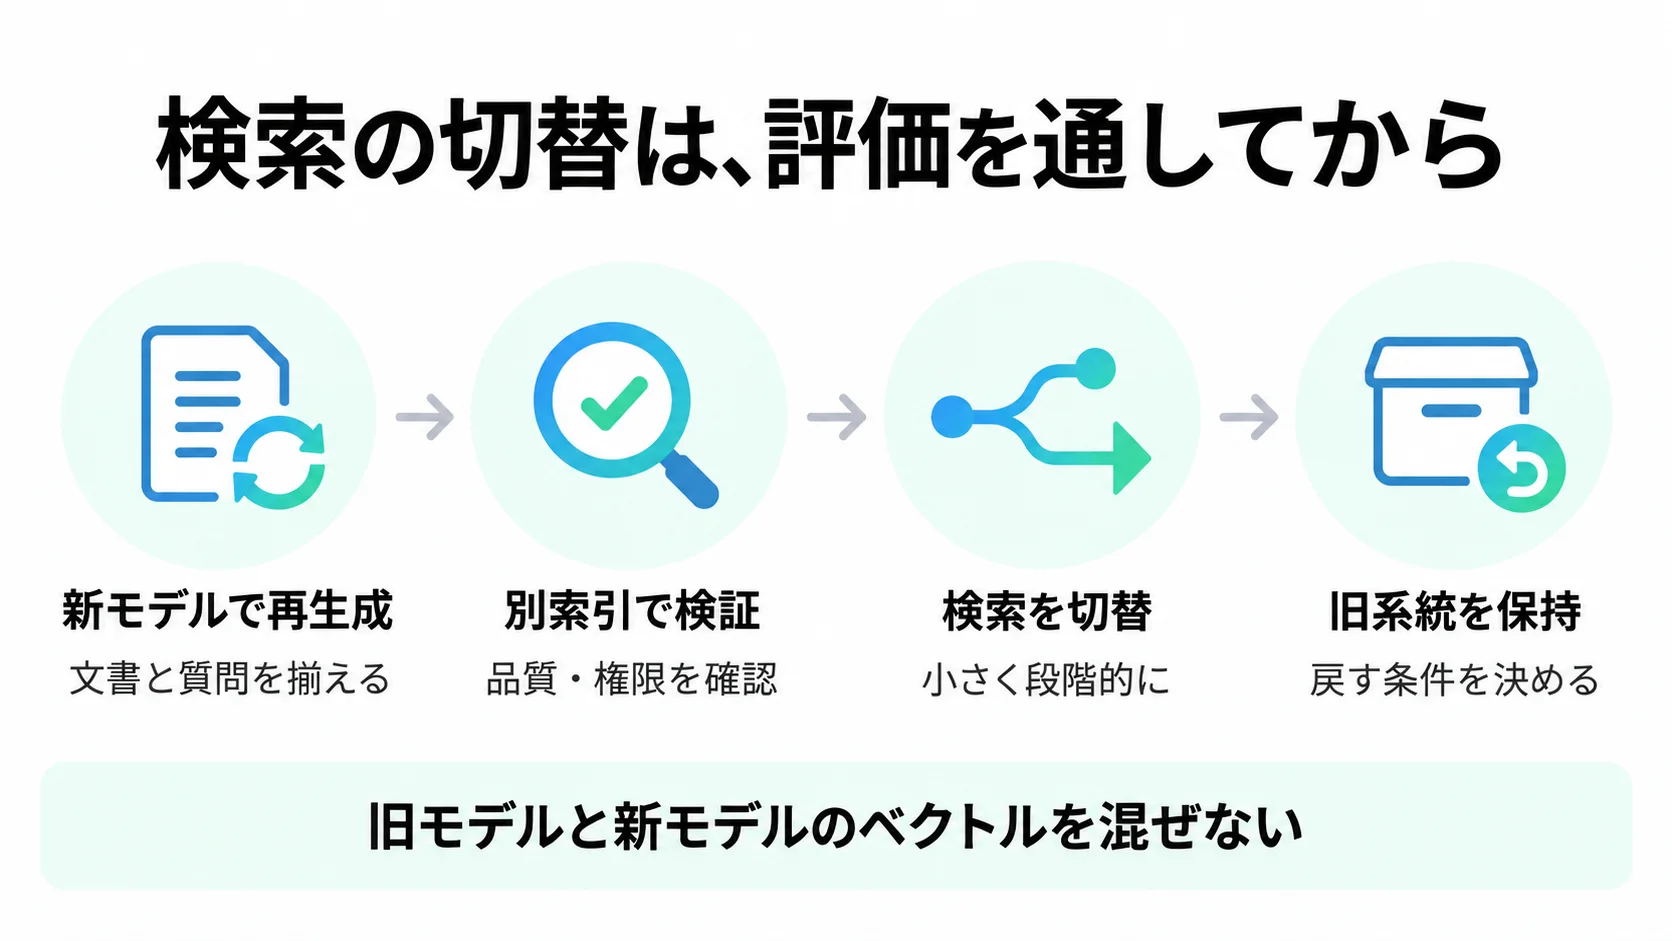
結論から言うと、移行は「新しいベクトルを作る」「新しいインデックスで検索品質と権限を確認する」「文書側とクエリ側を互換性のある設定の組として段階的に切り替える」「旧系統を復旧用に保持する」の4工程で進めます。旧モデルと新モデルのベクトルは混ぜず、文書更新の取りこぼし、検索結果の関連性、レイテンシ、権限フィルターを確認してから本番の参照先を変えてください。
この手順は、RAG、社内検索、FAQ検索、営業資料検索など、検索結果を生成AIや業務画面へ渡すシステムに使えます。モデルの提供終了に伴う全体の変更管理はAIモデル廃止への変更管理で扱っているため、ここでは検索用ベクトルとインデックスの移行に範囲を絞ります。
本記事のポイント
- モデル変更時は文書を再埋め込みし、質問側と互換性のある設定の組を固定します。新旧のベクトルは混ぜません。
- 新しいベクトルは別インデックスで検索品質、権限、レイテンシ、コストを比較し、評価用クエリの合格条件を決めてから切り替えます。
- 本番は段階的に切り替え、文書の差分更新を追随させ、旧インデックスと復旧条件を一定期間保持します。
埋め込みモデルの変更で、なぜ再生成が必要になるのか
埋め込みは、入力の意味を浮動小数点の配列へ写像したものです。OpenAIの公式ガイドも、埋め込みをテキスト同士の関連性を測るベクトルと説明し、検索では質問と文書のベクトルを比較して関連度の高い文書を返す例を示しています。検索で比較できるのは、同じ尺度で作られたベクトル同士です。モデルを変えれば、同じ文章でも数値の並びと空間内の位置が変わるため、旧モデルの文書ベクトルに新モデルの質問ベクトルを掛け合わせる設計は原則として成立しません。
再生成とインデックスの再構築は分けて判断します。モデルや入力テキストが変わるなら、原則として対象文書を新モデルで再埋め込みします。一方、権限メタデータや検索設定だけの変更で、必ずモデルAPIを再実行する必要があるわけではありません。
| 変わるもの | 基本の対応 |
|---|---|
| モデルID・バージョン・入力指示・チャンク本文 | 対象文書を再埋め込みし、新しい質問の生成経路と組み合わせて評価する |
| 出力次元数・正規化 | モデルが保証する変換方法を確認する。保証がなければ再生成し、保存先の次元・検索設定を揃える |
| 距離尺度・近似検索のパラメーター | 互換性と再構築要否を確認する。既存ベクトルを使える場合も検索品質を再評価する |
| 権限・削除・テナント属性 | メタデータや検索フィルターを更新する。本文が不変なら通常は再埋め込み不要だが、失効情報を返さない検証が必要 |
文書と質問を「揃える」とは、文字列の前処理やタスク名を必ず同一にする意味ではありません。検索用モデルには文書用と質問用の異なる入力形式を組み合わせるものがあります。モデルの公式仕様が指定する一組の設定を、同じ設定版として管理します。たとえばGemini APIの現行資料では、gemini-embedding-001のtask_typeと、gemini-embedding-2でプロンプトに含めるタスク指示は異なる方式です。旧モデルのパラメーターをそのまま新モデルへ渡さず、文書用・質問用それぞれの対応を確認してください。
Google Cloudのテキスト埋め込みの公式ドキュメントでは、モデルが出力するベクトルの次元数を指定でき、小さい次元数は保存容量と計算量を減らせる一方で品質とのトレードオフがあると説明されています。また、GoogleのVector Searchは密ベクトル、疎ベクトル、両者を組み合わせたハイブリッド検索を区別しています。次元数や密・疎の構成が変わる場合は、古いインデックスをそのまま使えると決めず、検索基盤のスキーマと移行方法を確認します。
距離尺度も契約の一部です。OpenAIの公式ガイドでは、埋め込みが長さ1に正規化されるため、コサイン類似度、内積、ユークリッド距離で同じ順位になる場合があるとされています。これはOpenAIの仕様に基づく説明であり、別のモデルにも自動的に当てはまるわけではありません。Pineconeの公式ドキュメントも、密ベクトルのインデックスではモデルの学習に使われた類似度尺度を選ぶよう案内しています。移行時は、旧システムの距離尺度を引き継ぐのか、新モデルに合わせるのかを明記し、両方を同じ評価データで測ります。
Qdrantの公式ドキュメントでは、同じcollection内のベクトルは原則として同じ次元数で、1つの距離尺度で比較すると説明されています。異なる次元数や尺度を併用するnamed vectorという例外もありますが、既存のベクトル列へ別モデルの値を混ぜてよいという意味ではありません。Qdrantは新しいニューラルネットワークへ移行するとき、別collectionをバックグラウンドで構築し、aliasを切り替える方法も案内しています。ただしaliasが変えるのは検索基盤の参照先です。アプリ側のクエリエンコーダー、次元数、距離尺度、権限フィルター、設定版まで同じ切替条件で管理しなければ、aliasを一度切り替えるだけでは移行完了になりません。
| 移行対象 | 確認する設定 | 不一致が起きた場合 |
|---|---|---|
| モデル | 提供元、モデルID、バージョン、文書用・クエリ用のタスク | 文書とクエリを新モデルで揃えて再生成 |
| ベクトル | 次元数、正規化、データ型、生成時のエラーと欠落 | 次元を固定した新インデックスを用意し、件数とハッシュを照合 |
| 検索 | コサイン、内積、ユークリッド、top-k、再ランキング | 旧新の順位を同じ評価集合で比較し、スコア閾値は系統別に校正 |
| 入力 | チャンク境界、重なり、前処理、言語、メタデータ | 入力の版を固定し、変換前後の文書IDを追跡 |
| 権限 | テナント、部署、顧客、公開範囲、削除状態 | 検索前フィルターを含む漏えいテストを実施 |
移行前に文書・クエリ・インデックスの対応表を作る
最初に、現在の検索を再現できる状態にします。文書の原本、チャンク分割後の内容、ベクトルID、インデックス名、モデル設定、メタデータ、更新時刻、権限フィルターを一つの移行台帳へ記録してください。文書を再取得できないままベクトルだけを持っている場合は、再生成の前に原本の回収と欠落の確認が必要です。
次に、実際の質問を代表する評価用のクエリ集合を作ります。検索ログから頻度の高い質問だけを抜き出すと、長い文書、固有名詞、表記揺れ、権限で見えない文書、結果がない質問が欠けます。少なくとも、正解文書を1件以上特定できる質問、複数の正解候補がある質問、答えが存在しない質問、似た名前の顧客や製品を区別する質問を含めます。正解文書のIDと、表示してよいテナント・部署を評価データに持たせます。
文書の更新を止められないシステムでは、再生成を始める前にスナップショット時刻と増分更新の境界を決めます。スナップショットより後に作成・更新・削除された文書を別キューへ記録し、バックフィルが終わった後に新モデル側へ適用します。削除を新インデックスへ反映し忘れると、検索結果の古さだけでなく、アクセス権が失効した情報の表示につながります。
| 台帳の項目 | 記録例 | 移行で使う目的 |
|---|---|---|
| 原本と版 | 文書ID、版番号、更新時刻、削除フラグ | 再生成対象と増分差分を決める |
| チャンク | チャンクID、順序、本文ハッシュ、分割設定 | 同じ入力が新旧に入ったか照合する |
| ベクトル設定 | モデル、次元、正規化、距離、生成日時 | 異なる空間の混在を防ぐ |
| インデックス | 名前、環境、namespace、作成時刻、状態 | 読み書き先と切替先を特定する |
| 権限 | テナント、部署、閲覧条件、フィルター結果 | 検索結果の越境を検出する |
| クエリ評価 | 質問、正解ID、許可範囲、期待順位 | 旧新の検索品質を比較する |
この台帳は、モデル廃止の変更管理で作る利用箇所一覧と似ていますが、検索移行ではさらに「どの文書版がどのベクトルになったか」を追跡できる必要があります。対象システムの実行ログや例外、承認、復旧条件までまとめるときはAIエージェント運用Runbookの考え方も参考になります。

再生成から段階切替までを7つの手順で進める
移行は一度に全量を書き換えるのではなく、対象を追跡できる単位に分けます。次の順序なら、文書更新が続く環境でも現在の検索を維持しながら新系統を検証できます。
- 現行設定と基準データを固定する。旧モデルの設定、インデックスのスナップショット、評価用クエリ、結果の順位、レイテンシ、エラー率を保存します。スナップショット以降の作成・更新・削除は差分キューへ送ります。
- 新しい設定を固定する。モデルIDとバージョンだけでなく、文書と質問のタスク指定、チャンク分割、前処理、次元数、正規化、距離尺度、top-kを一つの設定ファイルや設定レコードへまとめます。設定の一部だけをコードの既定値に任せないでください。
- 文書ベクトルを新モデルで再生成する。文書ID、版、チャンクID、設定版を一緒に保存し、入力件数、成功件数、失敗件数、再試行件数、欠落IDを記録します。大きなバックフィルではバッチを小さく分け、途中から再開できるチェックポイントを持たせます。再試行しても同じ文書版が二重登録されないID設計にします。
- 別インデックスへ投入する。新しい次元数や距離尺度に合わせて、旧インデックスと分離した保存先を作ります。Google Cloud Vector Searchでは、全体置換、バッチの部分更新、ストリーミングの部分更新、メタデータ更新という更新方法が分かれているため、利用する検索基盤の更新方式を確認してください。新旧のベクトルを同一namespaceや同一検索対象へ混ぜず、名前と設定版で読み書き先を区別します。
- 検索品質と安全性を比較する。評価用クエリを旧新の両方へ送り、正解文書の順位、top-kの再現率、MRRまたはnDCG、該当なし判定、レイテンシ、コストを比べます。権限フィルターを適用した結果も比較し、見えてはいけない文書が候補へ出ないことを確認します。検索で得た文書を生成AIへ渡す場合は、検索評価と回答評価を分けて測ります。
- クエリ側を段階的に切り替える。まず本番トラフィックの複製を新インデックスへ送り、ユーザーには旧結果を返すシャドー検証を行います。条件を満たしたら、機能フラグ、テナント単位、部署単位、トラフィック割合など、戻せる単位で新インデックスを参照します。文書とクエリが対応するモデルと同じ設定版を使っていることを、リクエストログでも確認します。
- 増分更新を揃え、旧系統を保持する。切替中に変更された文書は、新旧の更新キューへ確実に反映します。削除、権限変更、期限切れも更新として扱います。新系統が安定した後も、あらかじめ決めた復旧期間は旧インデックスを読み取り可能な状態で保持し、旧参照先へ戻せるフラグ、連絡先、判断者、切替時刻を記録します。
Google Cloudの公式ドキュメントが示すように、既存のVector Searchインデックスには全体置換と部分更新の両方があります。小さな差分を反映できる仕組みがあっても、モデル空間が変わる移行では、まず新モデルで全対象を再生成して新インデックスを作り、その後に差分更新を適用する順序が安全です。既存インデックスの一部だけ新モデルへ更新し、残りを旧モデルのままにする方式は、検索結果のスコアと順位を一貫して扱えません。
新旧の検索品質を比較し、切替条件を決める
「新モデルの方が高性能」という説明だけで切り替えず、自社の検索目的に合わせた合格条件を決めます。正解文書が上位に来るかだけでなく、権限、速度、コスト、運用の復旧性を同じ表で確認します。スコアの絶対値はモデルや距離尺度が変わると比較できないため、新旧の数値をそのまま横並びにして閾値を流用しないでください。
| 観点 | 測定方法 | 切替前に見ること |
|---|---|---|
| 関連性 | Recall@k、Hit@k、MRR、nDCG、担当者のブラインド評価 | 重要クエリの正解が下がっていないか、改善が特定分野に偏っていないか |
| 該当なし | 正解文書がない質問を混ぜて誤ヒット率を測る | 無理に近い文書を返し、誤回答の根拠にしていないか |
| 権限 | テナント・部署・顧客をまたぐクエリと失効文書で検証 | 検索前フィルターが新インデックスでも同じように効くか |
| 性能 | p50・p95レイテンシ、タイムアウト、エラー率、再試行率 | 次元数やインデックス構成が応答時間を押し上げていないか |
| 費用 | 再生成費用、保存容量、検索単価、バックフィル時間 | 一時的な二重運用期間を含めても許容できるか |
| 運用 | 差分反映の遅延、欠落、復旧操作のリハーサル | 障害時に旧系統へ戻す条件と担当者が明確か |
評価用の正解は、単語が一致した文書だけに限定しません。質問者が必要とする事実を含み、現在の権限で表示でき、適切な版であることを正解条件にします。たとえば社内規程検索なら、古い版が上位に出るだけでなく、異動後の部署には旧部署の規程が出ないことも評価します。営業資料検索なら、顧客名の似た別会社の資料を返さないこと、公開前の提案書を権限外の担当者へ出さないことを確認します。
検索結果をRAGへ渡す構成では、検索の正解率が改善しても回答が改善するとは限りません。top-kの文書が増えると、文脈が長くなって回答が散ることがあります。まず検索単体で順位と権限を合格させ、その後に根拠引用、回答の正確性、拒否条件を評価します。Gemini Embedding 2のマルチモーダル検索のように入力形式が広がる場合も、モデル紹介の性能値だけで判断せず、実際のPDF、画像、音声など自社データで同じ評価を行ってください。
切替後の更新とロールバックを運用に組み込む
切替の瞬間に検索参照先だけを変更すると、その前後で別系統へ文書が書き込まれることがあります。リクエストに設定版とインデックス名を付け、文書更新のイベントにも同じ設定版を持たせてください。書き込みが成功した文書版、失敗して再試行中の文書版、削除待ちの文書版を分けると、バックフィルと差分キューの重複を検出できます。
バックフィルと差分反映の方法は、利用中のインデックスが受け付ける更新方式に合わせます。Google Cloud Vector Searchの公式資料は、バッチインデックスとストリーミングインデックスの更新を別手順で説明しています。「最初はバッチ、後から同じインデックスを自由にストリーミングへ変更できる」とは解釈せず、作成時の方式、変更可否、取り込み遅延を確認してください。大量の文書を分割処理するバッチ作業と、製品が定義するバッチ更新方式も別の概念です。次元数や距離尺度を既存インデックスで変更できない場合は、新しい保存先を用意します。
ロールバック条件は「なんとなく結果が悪い」ではなく、事前に数値と事象で定義します。たとえば重要クエリのHit@k低下、権限漏れの検出、p95レイテンシの上限超過、更新遅延、エラー率の上昇を復旧条件にします。条件に達したら、新系統への読み取り割合を0へ戻し、旧モデルのクエリ生成と旧インデックスの組へ戻します。ただし、戻す前に旧系統へ削除・権限変更・必要な文書差分が反映済みか確認します。未反映なら対象検索を制限または停止し、差分を適用して安全性を確認してから再開します。復旧後は、原因がモデル、分割、フィルター、インデックス更新のどこにあるかを分けて調べます。
旧インデックスを削除する時期も先に決めます。新系統の検証が終わった直後に削除すると、検索品質の悪化や遅れて発見された権限問題を調査できません。復旧期間中も旧系統へ削除・権限変更・必要な文書更新を追随させ、スナップショット、設定、評価結果、切替ログを保存します。保存用スナップショットを読み取り専用にすることと、本番へ戻せる旧検索を更新することは分けて管理します。旧モデルのAPIが停止する場合は、旧インデックスだけ残しても新しい質問を処理できません。切替期限を旧モデルの利用可能期間より前に置き、旧クエリ生成を使えない場合の代替経路や検索停止条件も決めます。保持期間を終えるときは、旧ベクトルを新インデックスへ混ぜるのではなく、旧系統を廃止したことと削除対象の文書版を記録します。
よくある質問
埋め込みモデルを変えたら既存ベクトルを再生成しますか?
モデルや入力本文が変わる場合は、原則として対象文書を再埋め込みします。ただし、権限メタデータ、距離尺度、近似検索の設定だけの変更は、ベクトル再生成とは分けて判断します。モデルが保証する次元短縮や既存ベクトルを利用できる場合も、保存先の互換性と検索結果を検証してください。
文書側とクエリ側のモデルはどう揃えますか?
モデルIDとバージョン、文書用・クエリ用それぞれのタスク指定と前処理、出力次元、正規化、距離尺度を、互換性のある一組の設定として管理します。文書と質問で異なる入力形式を指定するモデルでは、その公式仕様に従います。文書だけ新モデルに再生成し、クエリだけ旧モデルのままにする、またはその逆は避けます。移行中に本番の旧クエリを維持する場合は、旧インデックスへ旧モデルのクエリを送り、新インデックスへ新モデルのクエリを送る二つの経路を分けます。
新旧インデックスの検索品質はどう比較しますか?
代表的な質問に正解文書IDと閲覧可能範囲を付けた評価集合を作り、同じtop-kで旧新を検索します。Recall@k、Hit@k、MRRまたはnDCG、該当なしの誤ヒット、p95レイテンシ、エラー率、コストを測定し、重要クエリは担当者のブラインド評価も行います。スコアの絶対値ではなく、正解の順位、権限、速度、運用負荷を比較してください。
切替中に文書が更新されたらどうしますか?
バックフィル開始時点のスナップショットと、それ以降の作成・更新・削除を分けて管理します。差分イベントへ文書版と設定版を付け、新インデックスのバックフィル後に漏れなく適用します。切替期間は新旧双方へ書き込むか、少なくとも旧系統を復旧できる差分ログを持ち、削除と権限変更も通常の更新と同じ優先度で処理してください。
クエリ側を先に新モデルへ変えてもよいですか?
新モデルのクエリを旧インデックスへ送る形の先行切替は避けます。新インデックスが完成するまでは、本番のクエリを旧モデル・旧インデックスの組み合わせに残し、新モデル側はトラフィックを複製するシャドー検証にします。新インデックスで品質、権限、性能を確認した後、設定版を固定したままクエリと参照先を同じ段階で切り替えます。
旧インデックスはいつ削除できますか?
新系統の品質と権限を確認し、設定版、更新遅延、切替ログ、復旧手順を点検した後、定めた復旧期間を終えてから判断します。復旧条件を満たす場合に旧参照先へ戻せることをリハーサルし、保持期間中も削除・権限変更などを旧系統へ反映し、旧クエリ生成を実行できることと廃止条件を確認します。旧インデックスのベクトルを新インデックスへ混在させて延命するのではなく、旧系統を独立した復旧先として扱います。
参考情報
以下の公式ドキュメントを2026年9月17日に確認しています。上記の移行台帳、評価項目、段階切替と復旧条件は、これらの仕様を踏まえた運用上の推奨です。
埋め込み検索の移行設計を相談したい方へ
再生成対象の整理、新旧インデックスの評価、権限フィルター、段階切替やロールバックを自社の検索基盤へ落とし込みたい場合は、ファネルAiへのお問い合わせから状況をご相談ください。
