Gemini Embedding 2とは?対応入力・次元・料金と移行評価の進め方
Gemini Embedding 2(モデルコード gemini-embedding-2)は、GoogleがGemini APIとVertex AIで提供する埋め込みモデルです。埋め込みとは、文章や画像の内容を数値のベクトルに変え、意味の近いもの同士を探せるようにする処理で、RAGや社内検索の「探す」部分に使われます。2026年3月10日のGoogle公式発表ではPublic Previewとして紹介され、2026年10月26日時点のGemini APIドキュメント(2026年10月9日更新)では安定版(Stable)として掲載されています。
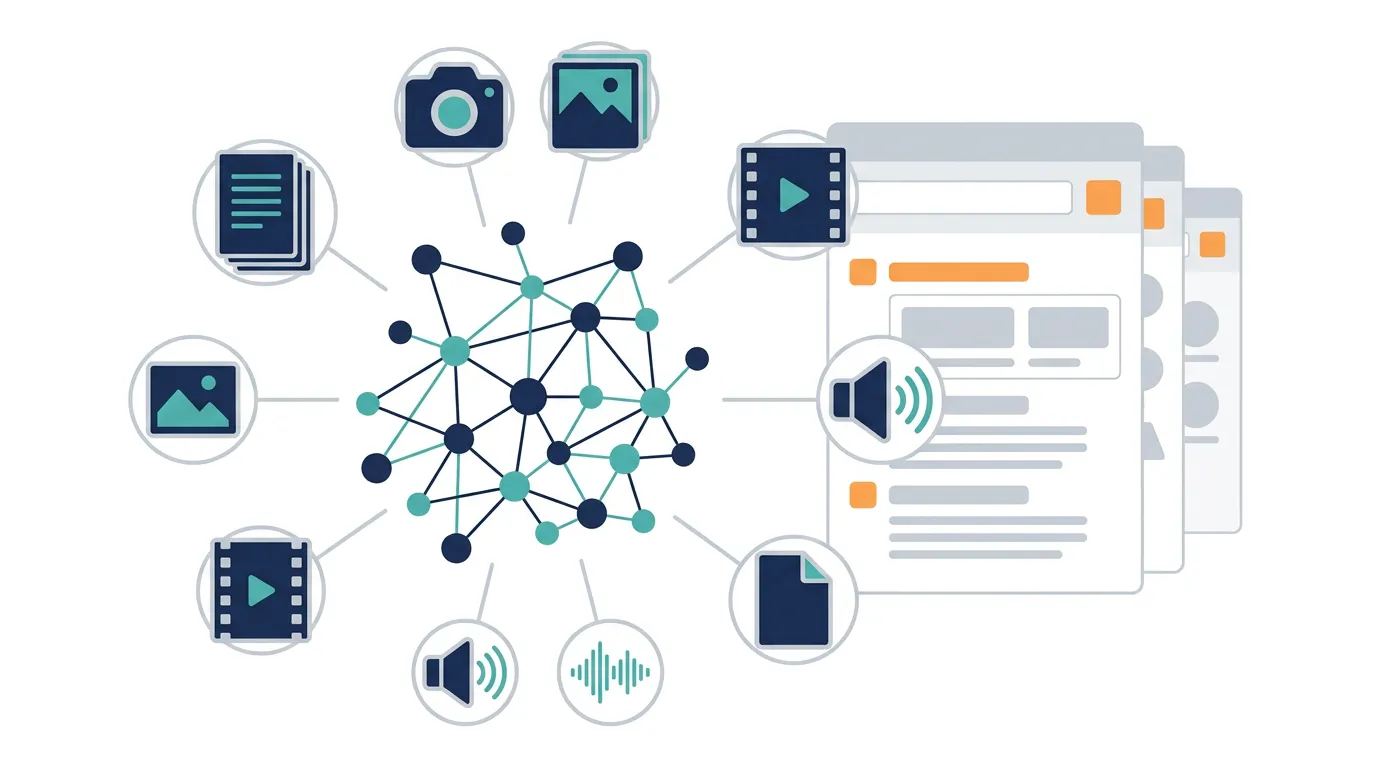
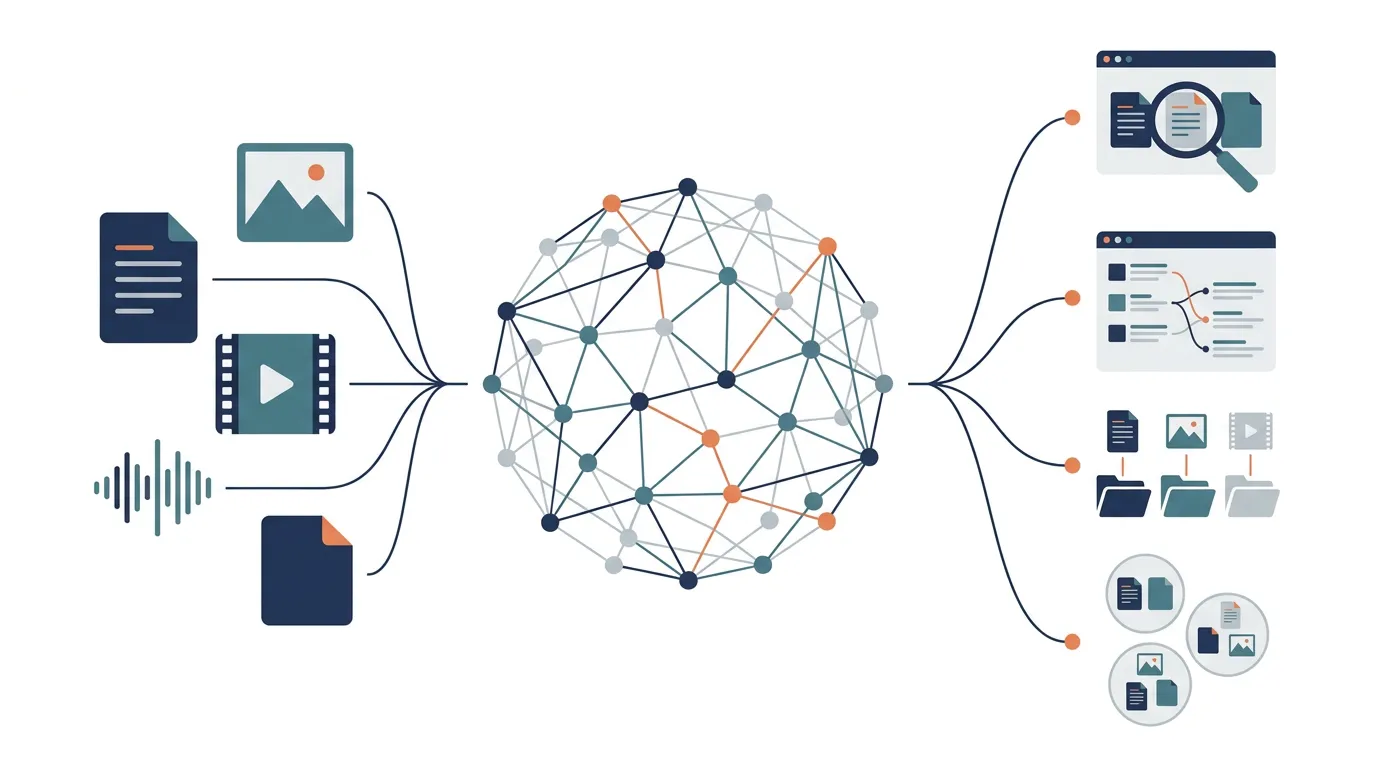
Gemini Embedding 2の特徴は、テキスト、画像、音声、動画、PDFを同じ埋め込み空間で扱えることです。出力は128〜3,072次元から選べ、料金はテキストが100万トークンあたり0.20ドル、画像が1枚あたり0.00012ドルなど入力の種類で異なります。従来の gemini-embedding-001 とはベクトルに互換性がないため、移るときは対象データをすべて作り直し、別のインデックスで検索品質を比べてから段階的に切り替えます。
本記事のポイント
- Gemini Embedding 2は、テキスト、画像、音声、動画、PDFを同じ埋め込み空間で扱え、出力を128〜3,072次元から選べる埋め込みモデルです。
- gemini-embedding-001とはベクトルに互換性がないため、移るときは対象データを作り直し、別インデックスで比べてから段階的に切り替えます。
- 上限超過の入力が通知なく切り詰められ、複数入力が1つの埋め込みにまとまる挙動があるため、チャンク分割と送り方を評価の前に決めます。
Gemini Embedding 2とは何か
エンベディングとは、文章、画像、音声などの内容を数値ベクトルに変換する技術です。意味が近いデータほどベクトル空間上で近くなるため、キーワード一致では拾いにくい情報検索、類似文書検索、分類、テーマリング、RAG の検索部分に使われます。
Googleの 公式発表 では、Gemini Embedding 2はGeminiアーキテクチャをもとにした初の本格的なマルチモーダル エンベディングモデルとして説明されています。テキスト、画像、動画、音声、ドキュメントを単一の埋め込み空間に写像し、100以上の言語にまたがる意味理解を扱えることが特徴です。
Gemini APIの エンベディング ドキュメント では、モデルコードは gemini-embedding-2 とされています。テキストのみの用途では gemini-embedding-001 も引き続き使えますが、画像、動画、音声、PDFまで含めた横断検索を設計するなら、Gemini Embedding 2を前提に検討する価値があります。
Gemini Embedding 2は、文章検索の部品ではなく、複数形式の業務データを同じ意味空間で扱うための検索・RAG基盤モデルです。
gemini-embedding-001との違いと移行の評価
従来の gemini-embedding-001 はテキスト向けのエンベディングモデルです。営業FAQ、社内ナレッジ、商品説明、議事録、ヘルプページなど、文字情報を検索対象にする場合は今でも選択肢になります。Gemini Embedding 2はそこから一歩進み、画像、動画、音声、PDFを同じ検索対象へ含められる点が大きな違いです。
| 比較軸 | gemini-embedding-001 | gemini-embedding-2 |
|---|---|---|
| 主な入力 | テキスト | テキスト、画像、動画、音声、PDF |
| 入力トークン上限 | 2,048 | 8,192 |
| 出力次元 | 128から3,072、推奨は768、1,536、3,072 | 128から3,072、推奨は768、1,536、3,072 |
| タスクタイプ指定 | RETRIEVAL_DOCUMENT などを指定 | タスクタイプ指定ではなく、テキスト用途では指示をプロンプト側へ含める |
| 移行互換性 | 既存インデックス内で継続利用できる | 001と直接比較できないため再埋め込みが必要 |
特に重要なのは互換性です。Gemini APIドキュメントでは、gemini-embedding-001 と gemini-embedding-2 の埋め込み空間は互換ではないと説明されています。つまり、既存のベクトルDBに001で作ったベクトルが入っている状態で、クエリだけGemini Embedding 2に切り替える、といった移行はできません。
移行するなら、文書、FAQ、営業資料、PDF、画像、動画などの検索対象をすべて新モデルで再埋め込みし、検索評価をやり直します。既存RAGの改善を狙う場合も、モデル差し替えだけで完了ではなく、チャンク設計、メタデータ、検索評価、回答品質評価まで同時に見直す必要があります。再生成から切替までの手順は 埋め込みモデルの移行手順 で整理しています。
既存の検索から移るときの評価例
ここでは、Gemini Embedding 2に特有の評価の組み方を示します。新しいモデルで作ったインデックスを現行のインデックスとは別に用意し、同じ評価用の質問で比べます。
| 比べる組み合わせ | 目的 | 確認すること |
|---|---|---|
| 現行モデル(例:gemini-embedding-001)と、テキストだけをGemini Embedding 2で作り直したもの | モデルを変えるだけで、今のテキスト検索が良くなるか悪くなるかを見る | 同じ評価用の質問で正解文書の順位、該当なしの誤ヒット、権限外の文書が出ないこと |
| Gemini Embedding 2の次元違い(768、1,536、3,072) | 品質と保存容量・検索速度の釣り合いを見る | 次元を下げたときに重要な質問の順位が下がらないか、保存容量と応答時間 |
| テキストに加えてPDFのページや画像を入れたもの | マルチモーダル化で探せるようになる情報があるかを見る | 図や写真でしか分からない資料が上位に来るか、テキストの検索結果を押し下げていないか |
001の設定(task_type の指定)をそのまま新モデルに渡すことはできません。Gemini Embedding 2では、テキストだけの入力に「task: search result | query: …」のようなタスクの接頭辞を付ける形に変わるため、文書側と質問側の書き方を評価の前に揃えます。画像などと一緒に送るテキストには、接頭辞を付けない形が一般に推奨されています。費用の見積もりでは、再生成するデータの量と入力の種類ごとの単価に加え、新旧インデックスを並行して持つ期間の保存費用も含めます。
新規に導入する場合も、最初から全データを対象にしない方が現実的です。たとえば、営業提案書PDFと商談メモだけ、問い合わせFAQとサポート音声だけ、製品画像と仕様書だけ、というように、探したいものがはっきりした1つの領域から評価を始めます。
マルチモーダル検索とRAGで何が変わるか
Gemini Embedding 2が効くのは、検索対象がテキストだけではない業務です。たとえば、営業資料のPDF、展示会ブースの写真、商談録画、製品デモ動画、サポート通話、社内マニュアル、提案書、過去のクリエイティブをまとめて検索したい場合、従来はそれぞれをテキスト化してから検索基盤に入れる必要がありました。
テキスト化は今後も重要ですが、画像や音声の情報をすべて文字に変換すると、表情、構図、雰囲気、非言語情報、動画内の視覚的変化が落ちることがあります。Gemini Embedding 2は、画像や音声、動画を直接埋め込めるため、テキスト化だけに頼る検索よりも、元データの意味を残した検索設計に近づきます。
| 業務データ | 検索したいこと | 実務上の使い道 |
|---|---|---|
| 営業資料PDF | 似た提案構成、業界別の訴求、過去資料の再利用 | 提案書作成、商談準備、ナレッジ検索 |
| 商談録画 | 顧客が反応した場面、説明が詰まった場面、デモ内容 | 営業育成、FAQ整備、オンボーディング改善 |
| 商品画像・施工写真 | 似た見た目、用途、現場状況、比較対象 | 製造業、建材、EC、フィールドセールスの検索 |
| 音声ログ | 問い合わせ意図、感情、よくある質問、クレーム傾向 | CS分析、営業通話分析、品質管理 |
| 広告・LPクリエイティブ | 似た構図、訴求、業界、反応のよかったパターン | BtoBマーケティング、制作ナレッジ、ABテスト管理 |
RAGで見ると、Gemini Embedding 2は「検索対象を広げる」役割を持ちます。回答生成モデルそのものではなく、生成前に必要な根拠を探す部分に効きます。たとえば、営業担当者が「この業界向けに似た提案を探して」と聞いたときに、文章の議事録だけでなく、PDF資料、過去デモ動画、画像付き事例も候補に出せるようになります。
ただし、マルチモーダル化したからといって、すべてを一つの箱に放り込めばよいわけではありません。営業資料、契約書、録画、サポート音声は、権限、保存期間、利用目的が違います。検索精度だけを見て統合すると、閲覧権限のない資料が検索結果に混ざる、退職者の録画が残り続ける、顧客情報を不要に広げる、といった問題が起きます。Google Workspace上の顧客データを扱う場合は、Google Driveの顧客データをGeminiで扱う前の確認項目 と同じく、共有範囲とDLPを先に確認する必要があります。
仕様と料金、実装で見落としやすい挙動
2026年10月26日時点のGemini APIのドキュメントと料金ページ(2026年10月22日更新)をもとに、入力の種類ごとの上限と料金を整理します。
| 入力 | 1リクエストの上限 | 料金(有料枠の標準、100万トークンあたり) |
|---|---|---|
| テキスト | すべての入力の合計で8,192トークン | 0.20ドル |
| 画像 | 6枚まで、PNG・JPEG | 0.45ドル(1枚あたり0.00012ドル) |
| 音声 | 180秒まで、MP3・WAV | 6.50ドル(1秒あたり0.00016ドル) |
| 動画 | 120秒まで、MP4・MOV。最大32フレームを抽出し(32秒までは1秒に1フレーム、それより長い動画は均等に抽出)、音声トラックは処理しない | 12.00ドル(1フレームあたり0.00079ドル) |
| 1ファイル、6ページまで(1ページずつの入力を推奨)。1ページあたり画像として258トークンと、抽出したテキストのトークンを数える | 料金表に個別の行はない |
大量のデータを一度に埋め込む場合は、Batch APIを使うと既定価格の半額になります。無料枠でも標準の利用は無料で試せますが、Batchには無料枠がありません。料金は変わることがあるため、本番の見積もりの前に Gemini APIの料金ページ を確認してください。
出力次元は128から3,072まで柔軟に設定でき、Googleは高品質用途で3,072、1,536、768を推奨しています。次元数を大きくすると表現力は上がりやすい一方、ベクトルDBの保存容量、検索メモリ、インデックス再構築時間、コストが増えます。実務では、最初から最大次元だけで決めず、候補次元ごとに検索評価を行うべきです。
| 設計項目 | 見るべきポイント | 失敗しやすい判断 |
|---|---|---|
| 次元数 | 検索品質、保存容量、検索速度、再インデックス時間 | 最大次元なら常に最適だと決める |
| チャンク設計 | PDFや議事録をどの粒度で分けるか | 文章、PDF、動画を同じ粒度で切る |
| メタデータ | 部署、顧客、業界、日付、権限、ソース種別 | ベクトルだけ保存して絞り込みができない |
| 評価データ | 実際の検索クエリ、正解候補、NG候補 | デモ用の数件だけで本番判断する |
| 権限管理 | 検索時にユーザー権限でフィルタできるか | 取り込み時だけ権限を見て検索時に落とす |
また、Gemini Embedding 2では、デフォルト以外の次元でも自動正規化が導入されています。これは、セマンティック類似性をベクトルの大きさではなく方向で扱いやすくするための改善です。ただし、正規化の有無だけで検索品質が決まるわけではありません。RAGでは、埋め込みモデル、チャンク、メタデータ、再ランキング、プロンプト、回答評価が連動します。
検索やRAGへ組み込むときは、エラーにならないまま検索品質を下げる挙動が3つあります。
上限を超えた入力は通知なく切り詰められる
入力が8,192トークンを超えると、超えた部分は通知なく切り捨てられて埋め込まれます。エラーは出ないため、長い文書の後半が検索に引っかからない原因になります。文書はあらかじめ上限より短いチャンクに分け、分割後のトークン数を記録しておきます。
複数の入力をまとめて送ると、1つの埋め込みになる
1回のリクエストに複数の文章や画像をそのまま並べて入れると、それらをまとめた1つの埋め込みが返ります。チャンクごとに別々のベクトルが必要な場合は、入力ごとに分けて送ります。まとめて送った結果を1チャンク分と思い込むと、検索の単位が崩れます。
PDFは6ページまで、動画の音声は使われない
PDFは1リクエストあたり1ファイル・6ページまでで、Googleは1ページずつの入力を推奨しています。スキャンしたPDFは自動で文字認識されます。長いPDFはページ単位に分けて埋め込み、ページ番号をメタデータとして残すと、検索結果から該当ページを示せます。動画は最大32フレームを抽出して埋め込み、音声トラックは処理されません。話している内容で動画を探したい場合は、音声を別に埋め込むか文字起こしを併用します。
企業利用で確認すべき注意点
Gemini Embedding 2は便利ですが、扱うデータが広がるほどガバナンスも重くなります。特に、音声、動画、PDF、画像を検索対象に入れると、個人情報、契約情報、顧客名、顔、音声、未公開資料が混ざりやすくなります。入力データの権利と利用目的を確認せずに、全社ナレッジとして取り込むのは危険です。
1. 入力データの権利と同意を確認する
商談録画、通話音声、顧客資料、展示会写真、PDF契約書を埋め込む場合、そのデータを検索基盤に投入してよいかを確認します。生成AIに読ませるかどうか以前に、社内検索基盤へ保存してよいデータか、保存期間は何年か、削除依頼が来たらどう消すかを決めます。
2. ベクトルDBの権限を検索時に効かせる
取り込み時に部門別のフォルダを分けても、検索時に権限フィルタが効かなければ意味がありません。ユーザー、部署、顧客、案件、機密区分、公開可否をメタデータとして持ち、検索時に必ずフィルタできる設計が必要です。
3. 評価セットを作ってから本番化する
エンベディングモデルの良し悪しは、ベンチマークだけでは判断できません。自社の検索クエリ、自社の正解資料、自社のNG資料で評価します。営業現場なら「この業界向けの過去提案」「似た失注理由」「この機能を説明した動画」など、実際に検索される問いを集める必要があります。
4. 生成モデルと埋め込みモデルを混同しない
Gemini Embedding 2は回答文を生成するモデルではありません。検索対象をベクトル化し、関連する根拠を探すためのモデルです。RAGでは、埋め込みモデルで候補を探し、必要に応じて再ランキングし、生成モデルに根拠を渡して回答させます。検索品質と回答品質は分けて評価します。
5. 既存インデックスのロールバックを用意する
移行後に検索品質が下がったり、出てはいけない資料が出たりしたときにすぐ戻せるよう、新旧インデックスを一定期間並行して持ってから切り替えます。手順は 埋め込みモデルの移行手順 を参照してください。
企業の営業・マーケティング基盤では、Gemini Embedding 2を単体のAPIとして見るより、CRM、Google Drive、商談ログ、メール、フォーム、ナレッジベースの接続点として見るべきです。CRM側の顧客情報が崩れていると、どれだけ埋め込みモデルが強くても検索結果の権限管理や顧客単位の集約が難しくなります。CRMの情報設計は Headless CRMの選び方 のように、AIエージェントが扱う業務基盤として考える必要があります。
よくある質問
Gemini Embedding 2とは何ですか?
Gemini Embedding 2は、Googleが提供するマルチモーダル エンベディングモデルです。テキスト、画像、動画、音声、PDFを数値ベクトルへ変換し、RAG、セマンティック検索、分類、テーマリングなどに使えます。
Gemini Embedding 2とgemini-embedding-001の違いは何ですか?
大きな違いは、対応する入力データと互換性です。gemini-embedding-001はテキスト向けですが、Gemini Embedding 2はテキストに加えて画像、動画、音声、PDFも扱えます。ただし、両者のベクトル空間は互換ではないため、既存インデックスを直接混ぜて比較することはできません。
Gemini Embedding 2はRAGでどう使いますか?
RAGでは、社内文書、PDF、画像、動画、音声などをGemini Embedding 2でベクトル化し、ユーザーの質問に近い根拠を検索します。その根拠を生成モデルに渡すことで、回答の根拠を補強します。回答文を作る役割ではなく、根拠を探す役割だと考えると分かりやすいです。
出力次元は何を選べばよいですか?
Googleは768、1,536、3,072を推奨次元として示しています。品質を重視するなら大きい次元を試す価値がありますが、保存容量と検索コストも増えます。実務では、自社の評価セットで768、1,536、3,072を比較し、品質とコストのバランスで決めるのが現実的です。
Gemini Embedding 2へ移行するときの注意点は?
gemini-embedding-001や他のモデルのベクトルとは互換性がないため、対象データをすべて作り直し、別のインデックスで検索品質と権限を確認してから段階的に切り替えます。001の task_type は使えず、テキストにタスクの接頭辞を付ける形に変わる点も、文書側と質問側で揃えます。
Gemini Embedding 2の料金はいくらですか?
2026年10月26日時点のGemini APIの料金ページでは、有料枠の標準料金が100万トークンあたりテキスト0.20ドル、画像0.45ドル、音声6.50ドル、動画12.00ドルで、Batch APIはその半額です。無料枠でも標準の利用を試せます。料金は変わることがあるため、見積もりの前に料金ページを確認してください。
