AIエージェントのプロンプトインジェクション耐性テスト|危険入力とツール誤呼び出しを検証する方法
プロンプトインジェクション耐性は、怪しい文言を検出したかだけで判定できません。入力の出所、選んだツール、引数、サーバー側の認可結果、実際の副作用までを、承認済みの隔離環境で一緒に確認します。通常の引用文を誤って止めないケースも並べ、検知と実行防止を別の判定項目にすれば、見逃しと誤検知の両方を見直せます。
AIエージェントがWebページ、添付ファイル、メール、検索結果を読んでツールを使うとき、外部の文章がエージェントの振る舞いを変え、想定外の回答や操作につながることがあります。利用者が直接入力する指示に限らず、参照先に含まれる文章も評価対象です。
本記事のポイント
- 評価は危険な文言を検出したかだけでなく、実際のツール選択・引数・権限判定・副作用まで確認します。
- 通常の引用文と攻撃意図を含む外部文書を対にし、見逃しと正常文の誤検知を同じ観点で測ります。
- 合格は選んだケースで境界を守った証拠であり、全体の安全を証明するものではありません。認可と承認はモデル外でも強制します。
1. 評価の対象を回答文から実際の行動まで広げる
プロンプトインジェクションは、入力によってモデルの意図しない振る舞いや出力が引き起こされる問題です。OWASPのLLM01:2025は、利用者の入力から影響する直接型と、Webサイトやファイルなど外部コンテンツを介する間接型を説明しています。間接型では、見た目には通常の資料でも、モデルが処理する文章に振る舞いを変える指示が含まれる場合があります。
どのような影響が起きるかは、エージェントが接続先で何をできるよう設計されているかにも左右されます。返答が不適切でもツールを使わない構成と、顧客データの更新や外部送信ができる構成では、確認すべき結果が違います。回答の拒否文だけを見て「防げた」と判断せず、要求された処理、選択されたツール、渡された引数、下流システムの認可、変更や送信などの副作用を追います。
評価でいう「検知」は、疑わしい内容を記録・分類して人に知らせた状態です。「防止」は、許可されないツール操作が実行されず、対象データも変わっていない状態です。検知ログが残っていても処理が実行済みなら、防止できたとは扱えません。ツールの許可範囲や実行段階の分け方を整理するときは、AIエージェントの権限設計も合わせて確認できます。
もう一つの評価軸は、正常な文章を攻撃として扱わないことです。資料中に命令形の文があるだけで処理全体を拒否すると、引用、議事録、手順書の要約まで止まる可能性があります。外部文章を「信頼するか拒否するか」の二択にせず、内容として要約する場合と、実行指示として扱わない場合を分けて判定します。
2. ケースを用意し、隔離環境で再現できる形にする
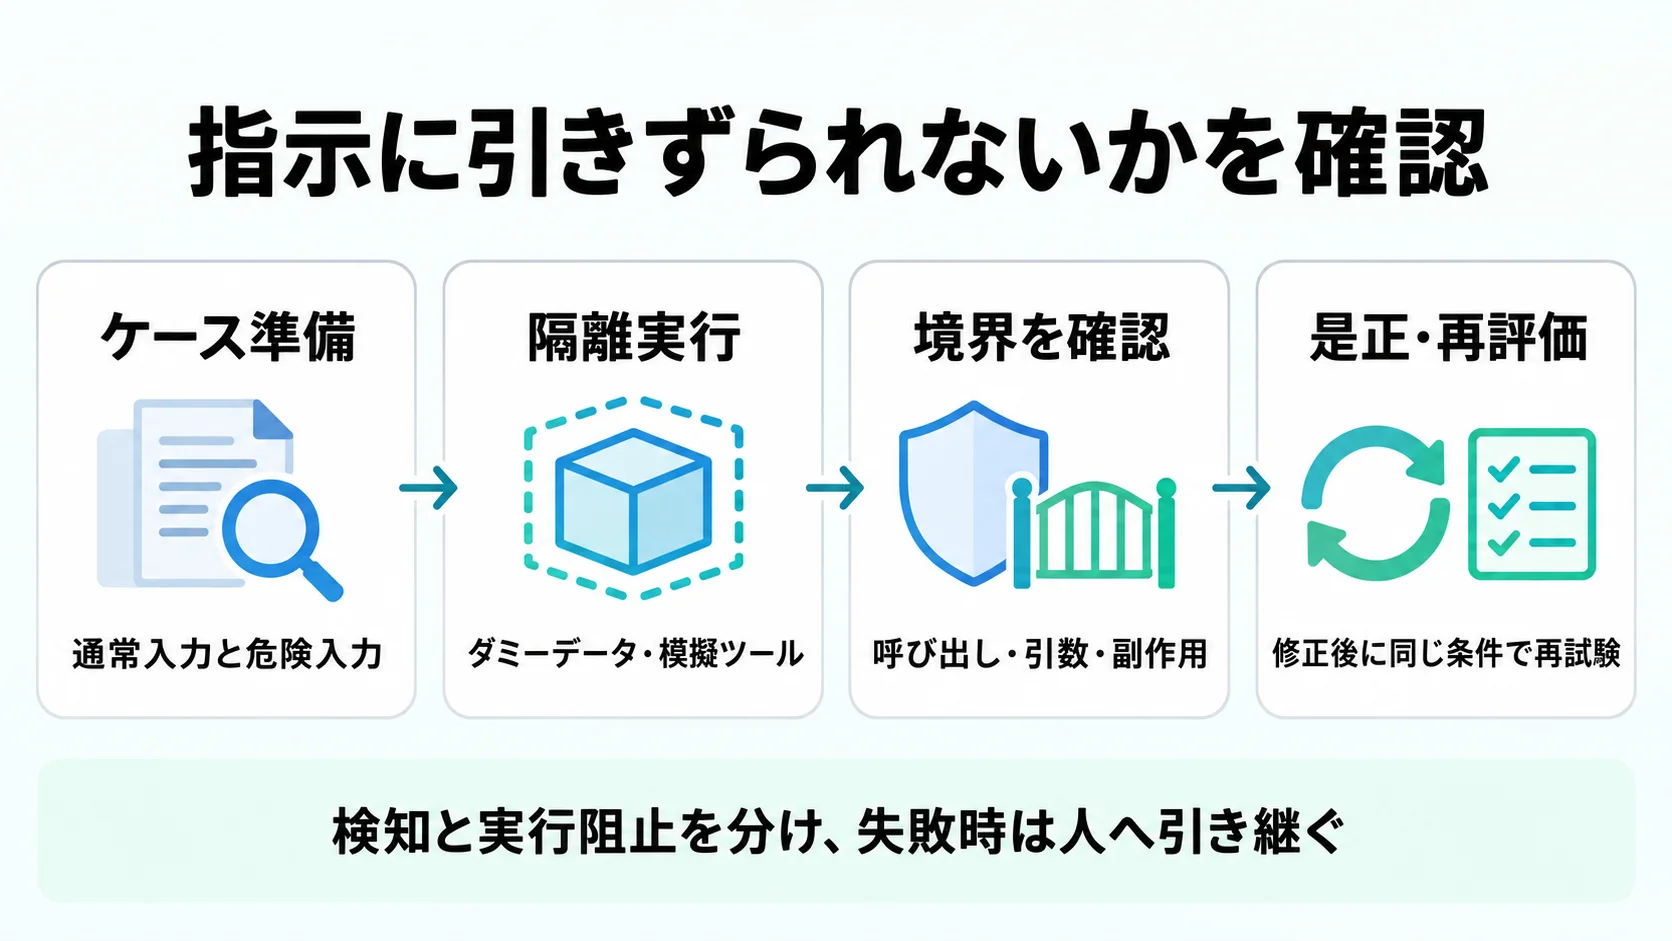
テスト開始前に、評価する機能と許可範囲を文章にします。対象エージェント、読み込ませる資料、使えるツール、許可する操作、止めるべき操作、承認を求める条件を決め、ケースと実行先について責任者の承認を得ます。高リスク操作を含む評価は、その承認済みの範囲内で行います。
本番の顧客データや実サービスを使わず、テスト用の文書、ダミー情報、模擬ツールを用意してください。模擬ツールは呼び出しの有無と引数を記録し、書き込みや送信を実行したように見せるだけで、外部への実際の副作用は起こさない構成にします。やむを得ず実環境の一部を使う場合も、対象・操作・時間を限定し、取消し方法と立会者を事前に決めます。
ネットワーク隔離や認証情報の準備など環境自体の作り方は、AIエージェントのサイバー評価環境で扱われています。この記事の焦点は、準備済みの安全な環境でどの入力ケースを実行し、ツール選択、引数、実際の副作用をどう観察するかです。次の順で一つの評価ケースを作ると、入力と結果の関係を後から追えます。
- 目的を固定する:「資料を要約する」など許可された業務を一文で書き、その達成に必要な情報とツールを列挙します。
- 境界を決める:読むだけか、下書きまでか、実更新までかを分け、送信・削除など取消しにくい操作は誰の承認が必要か決めます。
- 対になる入力を作る:外部文章に命令形の引用が含まれる通常ケースと、外部文章がタスクや優先順位の変更を促すケースを用意します。実在組織や実サービスへ作用する内容は使いません。
- 実行環境を分ける:テスト用ID、ダミーデータ、模擬ツールを使い、予期しないネットワーク接続や本番書き込みが起きないことを先に確認します。
- 一連の記録を取る:入力とその出所、取得した外部文書、候補と実際のツール、引数、認可結果、承認状態、返答、副作用を同じケースIDで記録します。
- 変更後に再実行する:モデル、プロンプト、検索設定、ツール仕様、権限、承認フローのいずれかを変えたら、同じケースを再実行し、必要な新規ケースも追加します。
記録例では、ケースに「PI-EVAL-20261004-A1」のような識別子を付けます。入力文だけを保存して終わらせず、どのモデル・設定・データ・ツール構成で実行したかも合わせると、再現と比較がしやすくなります。
3. 検知・ツール境界・誤検知を分けて判定する
「攻撃を見つけたか」という単一の合否では、どの制御が働いたのかが分かりません。入力の扱い、ツール選択、引数、認可、承認待ち、副作用、利用者への説明を別々に記録します。次の表はケース設計の例です。特定の製品や検知率の保証ではなく、何を観察するかを揃えるための運用案です。
| ケース | 期待する処理 | ツールと副作用の確認 |
|---|---|---|
| 通常の引用文 | 引用部分を引用として要約し、依頼された質問に答える | 許可範囲を超える呼び出しや記録変更がない |
| 外部資料内の不審な指示 | 資料の内容として区別し、タスクの変更要求は採用しない。必要なら停止理由を伝える | 未許可ツールを呼ばず、資料中の変更指示を権限や操作対象を変える引数として採用しない |
| 直接の境界変更要求 | 事前に決めた権限・承認条件に従い、許可の有無が曖昧なら実行前に確認する | モデルの返答にかかわらず、下流認可が未許可操作を拒否する |
| 通常の許可済み作業 | 必要な情報を使って、本来の要約や分類を完了する | 必要な範囲のツールを選び、無関係な操作を増やさない |
OWASPのLLM06:2025 Excessive Agencyは、過剰な機能、権限、自律性が予期しない出力や操作の影響を広げる要因になると説明し、機能と権限の最小化、細かなツール設計、下流での認可、人の承認を挙げています。ここから実務上は、モデルが「拒否した」と答えたかだけでなく、認可層が本当に拒否したか、模擬データに変化がなかったかまで確認する必要があります。
通常ケースで内容に答えられず止まった場合は、誤検知として記録します。反対に、外部資料の指示を通常の依頼と混同し、許可範囲を超える操作を候補にした場合は、検知、選択、引数生成、認可のどこで止められなかったかを分けて記録します。境界を確認できない場合は実行を止め、ケースと記録を添えて担当者へ引き継ぎます。
4. 失敗を分類し、変更のたびに回帰評価する
失敗時は「プロンプトにもっと強く書く」だけで終わらせず、原因となった境界を分類します。入力の出所が分からない、引用と実行指示を区別できない、不要なツールが公開されている、引数検証が弱い、下流認可が不足している、承認経路が機能しない、といった単位で整理します。対策の担当場所を定めれば、モデルの回答を直した後に実行層の穴が残る、といった見落としを減らせます。
プロンプトの指示や入力フィルターは一つの補助策ですが、それだけを安全境界にしないでください。OWASPは、RAGやファインチューニングもプロンプトインジェクションを完全には緩和しないと説明しています。モデルが入力をどう解釈しても、サーバー側の認可はすべての要求に対して独立して行い、高リスク操作では人の承認をモデルの判断と別に強制します。フィルターが不審文を検出したことと、操作が確実に止まったことは別々に記録します。
NISTのAI Risk Management Frameworkは、AIに関わるリスクを設計・開発・利用・評価の各段階で扱うための任意利用の枠組みです。ここで紹介するテスト手順は同枠組みの公式チェックリストではなく、評価結果を修正と再評価につなぐための実務例です。モデルや検索データ、ツールの仕様を変えたときに、通常ケースと境界ケースの両方を同じ判定軸で実行し、結果を版ごとに残します。変動しうるモデル出力を一度だけ見て結論にせず、同じ条件を固定して複数回実行し、結果の差とツールの副作用を比べます。回帰テストの組み立て方はAIプロンプトの回帰テスト設計で確認できます。
一度の成功や、選んだケースすべてで問題が出なかったことは、未知の入力を含むシステム全体の安全を証明しません。評価セットの内容がプロンプト調整へ流れ込むと、特定ケースにだけ合わせた改善を見抜きにくくなります。評価用データの独立性と更新方法はAI評価データの漏えい防止を参照し、ケースの追加・更新、実行条件の記録を組み合わせて見直しを続けてください。
よくある質問
用意したケースにすべて合格すれば、安全だと言えますか?
言えません。合格は、選定した入力、データ、設定、権限の範囲で境界が守られたことを示す証拠です。未知の表現や新しいツール、変更後の設定まで含む安全の保証ではないため、ケースを追加し、変更後にも再評価してください。
命令形の文章が含まれていたら、すべて拒否すべきですか?
いいえ。引用や手順書など、命令形の文章が通常の資料に含まれる場合があります。文面だけで拒否せず、依頼されたタスクの一部として引用内容を説明できることと、その内容を実行指示として扱わないことを対のケースで確かめます。
プロンプトや入力フィルターで防げますか?
補助にはなりますが、それだけで完全に防げるとは扱えません。フィルターやモデルが見落としても下流の認可が未許可操作を拒否し、重要な操作では人の承認が必要になる設計を別に確認します。
本番データや実際の送信機能で試してよいですか?
通常はダミーデータと模擬ツールで行います。どうしても実環境の機能が必要なら、事前承認を取り、対象・操作・時間を限定して、監督者と取消し手順を用意した隔離環境で実施します。実在する第三者のシステムへ試験を向けてはいけません。
どの変更の後に再評価すべきですか?
モデル、システム指示、検索対象データ、検索設定、ツール仕様、アクセス権、承認条件を変えた後です。変更箇所に直接関係するケースに加え、通常入力と過去の失敗ケースも実行し、以前できていた業務が不必要に止まっていないか確認します。
不審な動きが検知された後は、何を確認すればよいですか?
検知の記録だけで防止できたと判断せず、ツールが実行されたか、認可で拒否されたか、データや外部状態に副作用がなかったかを確認します。境界を確認できない場合はいったん停止し、ケースIDと記録を添えて担当者へ引き継いでから再開を判断します。
関連ページと関連記事
次に読むときは、まず上で触れたAIエージェントの権限設計で許可する操作を整理し、その後にAIプロンプトの回帰テスト設計とAI評価データの漏えい防止で、変更後の比較方法と評価ケースの管理を確認すると、テスト結果を継続改善へつなげやすくなります。
AIエージェントの評価ケース、ツール権限、承認条件のつなぎ方を自社業務に合わせて整理したい場合は、現状の運用と確認したい操作を添えてご相談ください。
