robots.txtの変更管理|公開前検証・取得確認・クロール制御の誤設定を防ぐ方法
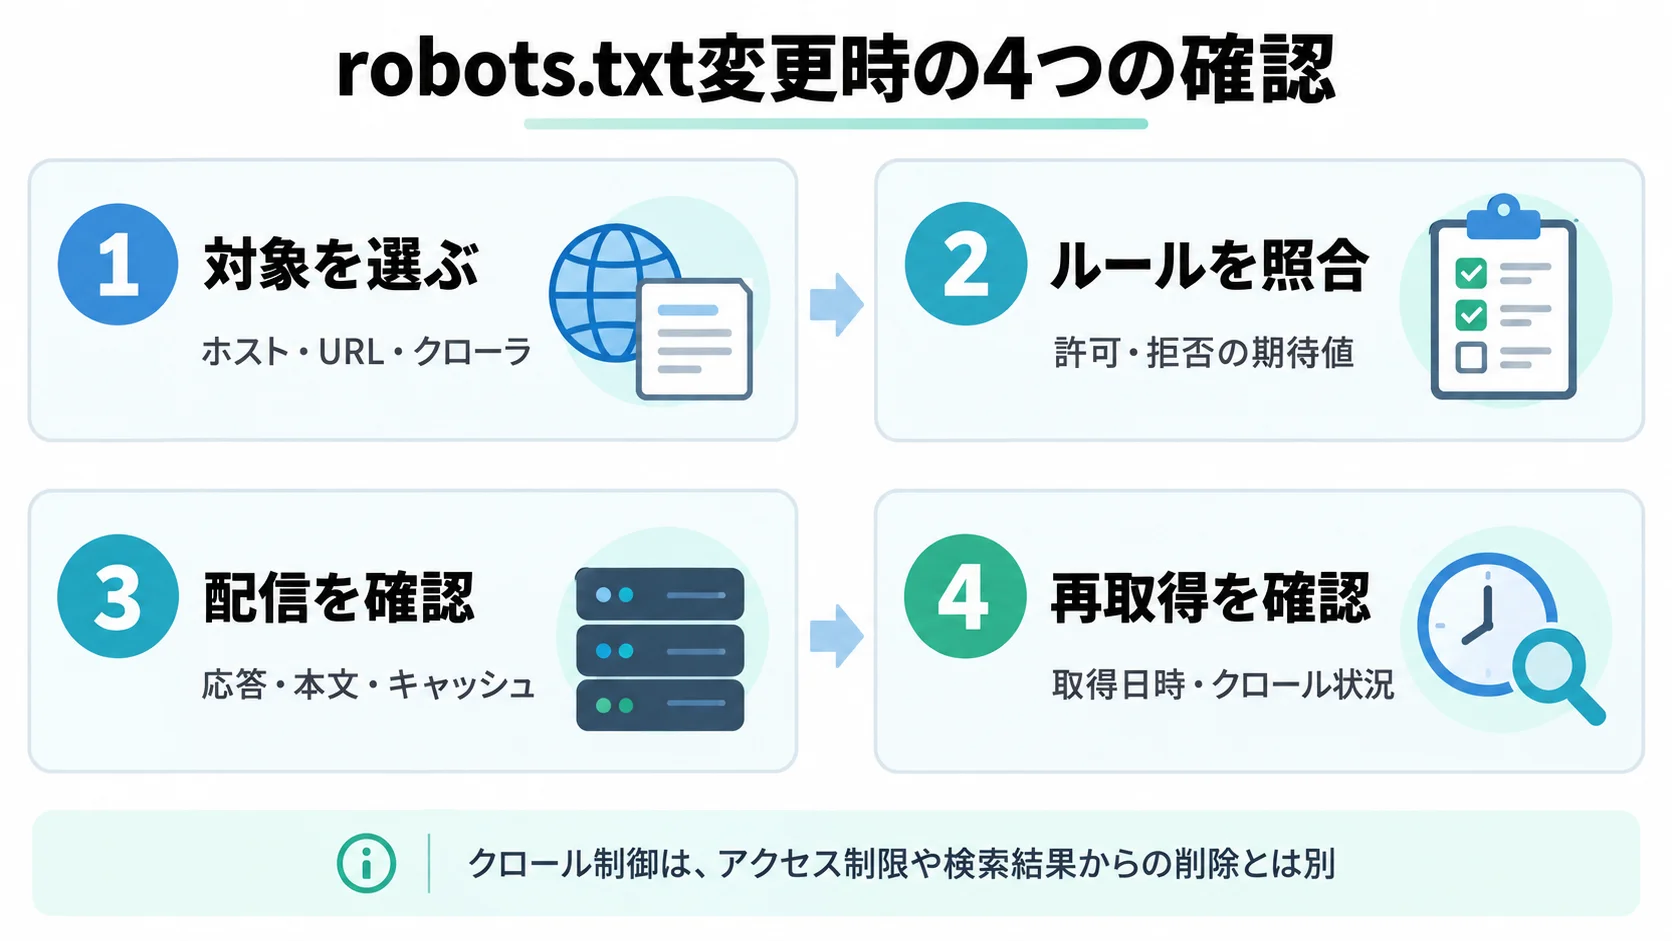
robots.txtを変更するときは、テキストを書き換えて公開するだけでは不十分です。対象ホストとURL、対象クローラを先に決め、Allow・Disallowの期待値を照合し、公開されたファイルの応答と本文を確認してから、時間を置いて再取得を確かめます。最も大切なのは、robots.txtはクロール制御の仕組みであり、アクセス制限や検索結果からの削除とは別だと理解することです。
robots.txtの変更では、書いた規則の正しさと、公開先で実際に返る内容の両方を確認します。Google固有の運用とRFC 9309の標準仕様を区別し、担当者が引き継げる記録を残します。サイト全体の設計から見直す場合は、ウェブサイト構築の進め方と合わせて、公開範囲と運用責任を整理してください。
先に答えると、robots.txtの変更は「対象を選ぶ→ルールを照合→配信を確認→再取得を確認」の4段階で検証します。 HTTP 200でUTF-8のプレーンテキストが返ること、意図したクローラのグループと最長一致するルールが期待どおりであること、変更後のキャッシュや再取得の時刻を記録することが確認の軸です。機密ページを守る場合は認証やアクセス制御を使い、検索結果から外したい場合はrobots.txtだけに任せません。
本記事のポイント
- robots.txtはクローラのアクセス可否を伝える仕組みで、認証によるアクセス制限や検索結果からの削除を代替しません。
- 対象クローラの最も具体的なグループを選び、URLパスに対する最も長い一致のAllow・Disallowを、変更前後の期待値表で照合します。
- 公開後はHTTP応答、本文、キャッシュ、再取得日時を分けて記録し、Googleの運用とRFC 9309の一般仕様の違いも障害判断に反映します。
robots.txtで決められる範囲と、決められない範囲
robots.txtは、サービスの最上位にある /robots.txt で、クローラに「どのパスを取得してよいか」を伝えるファイルです。RFC 9309はUTF-8・text/plainを定め、Googleもuser-agent、allow、disallow、sitemapを基本フィールドとして扱います。
Disallow: /admin/ と書けば、該当するクローラへのクロールを避けるための規則になります。しかし、これは利用者のアクセスを拒むファイアウォールやログイン画面ではありません。RFC 9309は、robots.txtにパスを記載すると、そのパス自体が公開されて発見可能になると注意しています。管理画面、顧客情報、未公開資料などを保護する場合は、HTTP認証、アプリケーションの認可、適切に設定したWAFのアクセス制限などを使います。
また、Googleはクロールを拒否したページの内容を取得できないため、ページ内の noindex を確認できません。それでもURLだけが検索結果に現れることがあります。検索結果から外したいページでは、クロール可能な状態で noindex を返す、認証で一般公開を止めるなど、目的に合う手段を選びます。robots.txtをnoindexの代わりに使うと、期待した削除にならないだけでなく、必要な確認もできなくなります。
Sitemap はクロールを許可する規則ではありません。Googleの仕様では、サイトマップまたはサイトマップインデックスの完全なURLを示すフィールドで、どのユーザーエージェントにも特定されません。URLを列挙して検索登録を保証するものでもないため、生成と送信の監視はXMLサイトマップの生成・送信監視として別に管理します。
変更前に対象と期待値を固定する
最初に変更の目的を一文にします。「管理画面のクロールを避ける」「公開記事の静的資源は取得させる」のように、対象と例外を具体化してください。次に、ホスト、パス、クローラを表にします。CDNやサブドメインがある場合、プロトコル・ホスト・ポートが違えばrobots.txtの適用範囲も別です。CDNのオリジン設定と公開ホストの対応も確認します。ルートの https://example.com/robots.txt を直しながら、www.example.com の挙動を変えたつもりにならないよう、ホスト単位で記録します。
| 確認対象 | 変更前に決めること | 検証する例 |
|---|---|---|
| ホスト | プロトコル、ホスト名、ポート、CDNの配信先 | 本番とステージングを混同していないか |
| URLパス | 拒否・許可するディレクトリ、ファイル、クエリ付きURL | /admin/は拒否し、/admin/help.htmlは許可するか |
| クローラ | 全クローラか、特定のproduct tokenか | Googlebot用のグループと * をどう分けるか |
| 目的 | クロール制御、検索結果除外、機密保護のどれか | robots.txt以外の手段が必要ではないか |
| 復旧 | 誤配信時に戻す版、承認者、確認URL | 直前の本文と配信設定をすぐ再現できるか |
期待値表には、代表URLを「許可」「拒否」「変更なし」に分けて最低1件ずつ入れます。/、対象ディレクトリ直下、深い階層、拡張子、エンコード済みURLを選ぶと、目視より誤りを見つけやすくなります。変更担当と取得確認担当が別なら承認欄に記録します。

GoogleとRFC 9309のルールを照合する
ルールの判定では、まずクローラに適用されるグループを選びます。Googleは、ユーザーエージェントに最も具体的に一致するグループを使い、特定クローラ用のグループと全体指定の * を混ぜて評価しません。RFC 9309も、product tokenに一致するグループを選び、一致するグループがなければ * を使う考え方を示しています。同じ対象クローラに一致するグループが複数あれば、その規則は統合して評価されます。記述順だけで優先順位が決まるわけではありません。
次に、URLパスの先頭からルールを比較します。RFC 9309は、最も多くのオクテットに一致する最も具体的な規則を使い、AllowとDisallowが同じ範囲で同等ならAllowを推奨します。Googleの説明でも、ルールのパス長が長いものを優先し、競合時にはより制限の少ない規則を使います。たとえば Allow: /private/public.html と Disallow: /private/ がある場合、前者が深いパスに一致するため、公開を意図したファイルを例外にできます。
ワイルドカードの意味も表に書きます。GoogleとRFC 9309が扱う * は0文字以上の任意の文字、$ は一致の終端です。Disallow: /*.pdf$ は末尾が .pdf のパス、Disallow: /*.pdf は後ろにクエリや文字が続く場合も対象にします。大小文字、末尾スラッシュ、エンコード済み文字も試します。
Googleの仕様では、UTF-8の生文字とパーセントエンコードされたパスを同じ意味として扱う例が示されています。一方、独自の検証スクリプトが単純な文字列検索だけなら、クローラの判定を再現できません。変更前後で使うテストツールがどの仕様を実装しているかを確認し、ツールの結果だけをGoogleの判定と断定しないことが重要です。
User-agent: *
        Disallow: /admin/
        Allow: /admin/help.html

        User-agent: Googlebot
        Disallow: /preview/

Sitemap: https://example.com/sitemap.xmlこの例では、Googlebotには専用グループが適用されるため、* の Disallow: /admin/ は適用されません。Googleの仕様では、特定グループとグローバルグループは統合されません。専用グループにも必要な拒否規則を明示するか、変更前の期待値で意図を確認してください。なおGoogleは crawl-delay など未対応のフィールドをサポート対象外としています。
上の設定を変更候補とした場合、次のような期待値を記録します。Googlebotで管理画面を拒否したいなら、このままでは要件に合いません。専用グループにも必要な拒否規則を追加し、期待値表を更新して再確認します。
| 対象クローラ | URLパス | 上の設定での判定 | 確認する理由 |
|---|---|---|---|
| Googlebot | /admin/report.html | 許可 | 専用グループにはadminの拒否がない |
| Googlebot | /preview/draft.html | 拒否 | 専用グループの拒否規則に一致 |
| 専用指定のないクローラ | /admin/report.html | 拒否 | 全体グループの拒否規則に一致 |
| 専用指定のないクローラ | /admin/help.html | 許可 | 長いパスの許可規則を優先 |
| 専用指定のないクローラ | /Admin/report.html | 許可 | パスの大文字と小文字を区別 |
公開後の応答と再取得を確認する
公開直後は、ブラウザで表示できたかだけでなく、HTTPレスポンスと本文を記録します。次のようにURLへ直接アクセスし、ステータス、Content-Type、キャッシュ関連ヘッダー、本文のハッシュまたは保存時刻を確認します。CDNを使う場合は、オリジンと公開エッジの両方を比較できるようにします。
curl -sS -D /tmp/robots-headers.txt \
          -o /tmp/robots-body.txt https://example.com/robots.txt
        cat /tmp/robots-headers.txt
        file /tmp/robots-body.txt
Google Search Centralでは、2xxの応答は提供されたrobots.txtとして処理されます。3xxは少なくとも5回のリダイレクトを追い、その後は404として扱う説明です。4xxは429を除き、有効なrobots.txtがない場合と同じで、クロール制限がないと仮定されます。5xxで新しいファイルを取得できない場合、最初の12時間はクロールを止めて再取得を試み、その後30日間は最後に正常だった版を使いながら再取得を続けます。キャッシュされた正常版がなければ、制限がないと仮定します。30日後も取得不能なら、サイト全体を取得できる場合はrobots.txtがないものとして扱い、サイト全体にも障害がある場合はクロール停止を続けるなど、状況に応じて分かれます。Googleは通常24時間までキャッシュしますが、取得不能時には長くなることがあります。
RFC 9309の定義は異なります。4xxなどの「unavailable」ではクローラはリソースへアクセスしてよいとし、5xxなどの「unreachable」ではrobots.txtが未定義のため完全な拒否を仮定します。ただし、到達不能が相当期間(例として30日)続く場合は、利用不能とみなすか、キャッシュを使い続けてもよいとされています。リダイレクトも5回を超えると利用不能とみなしてよい、キャッシュは到達不能でない限り24時間を超えて使うべきではない、という整理です。障害対応の手順書には「Googleでの実装上の挙動」と「プロトコルの一般仕様」を別欄で書き、RFCの規定をそのままGoogleの復旧時間と解釈しないようにします。
| 状況 | Google Search Central | RFC 9309 | 運用で残す記録 |
|---|---|---|---|
| 2xx | 取得した規則を処理 | 解析可能な規則に従う | 本文、Content-Type、取得時刻 |
| 4xx | 429以外は制限なしとして扱う | 利用不能のためアクセスしてよい | エラー時刻、監視通知、影響URL |
| 5xx | 停止、最後の正常版、再取得を段階処理 | 到達不能として完全拒否。長期化した場合の例外あり | オリジン・CDNの差、復旧版、再取得時刻 |
| 長いキャッシュ | 通常は最大24時間、取得不能時は長期化あり | 到達不能でなければ24時間超を避ける | Cache-Control、CDN更新、確認日時 |
再取得確認では、公開直後の1回を「反映完了」と呼ばないようにします。Search Consoleのrobots.txtレポートでGoogleの取得状況・取得日時を確認し、必要に応じて再クロールをリクエストします。これは即時反映の保証ではありません。サーバー・CDNログを使う場合は、User-Agent名だけでGooglebotと決めつけず、公式の送信元確認方法で確認します。本文の版と取得日時を記録し、ログに本文が残らない構成では、配信版とデプロイ時刻の対応表から追跡します。新しい版になるまで時間差があっても、HTTP応答、キャッシュ、Google側の時刻を分けて調べます。問題があれば直前版へ戻し、4段階を再実行します。
よくある質問
robots.txtで拒否すれば検索結果からページを消せますか?
消えるとは限りません。Googleは拒否したページの内容を取得できない一方、URL自体を検索結果に表示する場合があります。検索から外す目的なら、クロール可能な状態でnoindexを返す、認証を付ける、不要なURLを適切に廃止するなど、目的に応じた手段を選びます。
robots.txtは機密情報の保護に使えますか?
使えません。robots.txtは公開ファイルで、記載したパスが発見されやすくなります。管理画面や顧客データを守るには認証・認可をサーバー側で行い、robots.txtは検索クローラへのクロール方針を伝える補助として扱います。
AllowとDisallowが同じURLに当たるときはどちらが優先されますか?
最も具体的な、つまりパスの一致が長い規則が使われます。同じ範囲で競合する場合、Googleはより制限の少ない規則を使い、RFC 9309も同等のAllowを使うことを推奨しています。ツールごとの解釈差を避けるため、代表URLを実際に照合します。
robots.txtを200で返せば正しく反映されますか?
200は取得の入口にすぎません。本文がUTF-8のプレーンテキストであること、正しいホストから配信されていること、対象クローラのグループとパスの優先順位が意図どおりであることも確認します。HTMLエラーページを200で返す構成は、本文検証で検出します。
変更後すぐにGoogleのクロール結果へ反映されますか?
即時反映は保証されません。Googleはrobots.txtを通常24時間までキャッシュし、取得できないときは最後の正常版を長く使う場合があります。公開時刻、CDNの更新時刻、Google側の取得時刻を分けて記録し、必要な期間は旧版へ戻せるようにします。
Sitemapをrobots.txtに書けば、ページをクロールしてもらえますか?
SitemapはURLの場所を知らせるフィールドで、クロール許可を与える規則ではありません。Disallowに該当するURLをSitemapへ載せると、運用上の意図が衝突します。公開したい正規URLだけをSitemapへ載せ、生成・送信・登録状況は別の監視で確認します。
公式仕様を確認する
本文のルールとエラー時の整理は、2026年9月17日に確認した次の一次情報に基づきます。Google固有の運用説明と、標準仕様であるRFC 9309の差を分けて参照してください。
Webサイトのクロール制御と公開後の検証を見直したい方へ
対象URLの整理、変更承認、配信確認、検索エンジン向けの運用を自社のサイトに合わせて整えたい場合は、ファネルAiへのお問い合わせから状況をご相談ください。
