WebサイトのContent-Type検証|MIME宣言・nosniff・実体の不一致を見つける方法
ウェブサイト構築後に画像やJavaScript、CSSが突然読み込めなくなったとき、拡張子やファイル名だけを見ても原因は分かりません。HTTPレスポンスのContent-Typeが示す種類、Content-Encodingを復号した後の本文の実体、ブラウザがそのリソースを使う用途がそろって初めて、配信が意図どおりかを説明できます。CDNやオブジェクトストレージを経由するサイトでは、保存時のメタデータと公開URLの応答が別々に変わることもあります。
さらに、X-Content-Type-Options: nosniffを付ければすべてのMIME不一致が同じように拒否されるわけではありません。Fetch Standardは、nosniffによる拒否判定でscript-likeとstyleを分け、画像全般を対象にしていません。一方、Fetchにはnosniffとは別のMIME型による拒否判定もあります。仕様の対象範囲を混同せず、ヘッダー・本文・用途の順で検証することが、表示不具合と安全上の問題を切り分ける近道です。
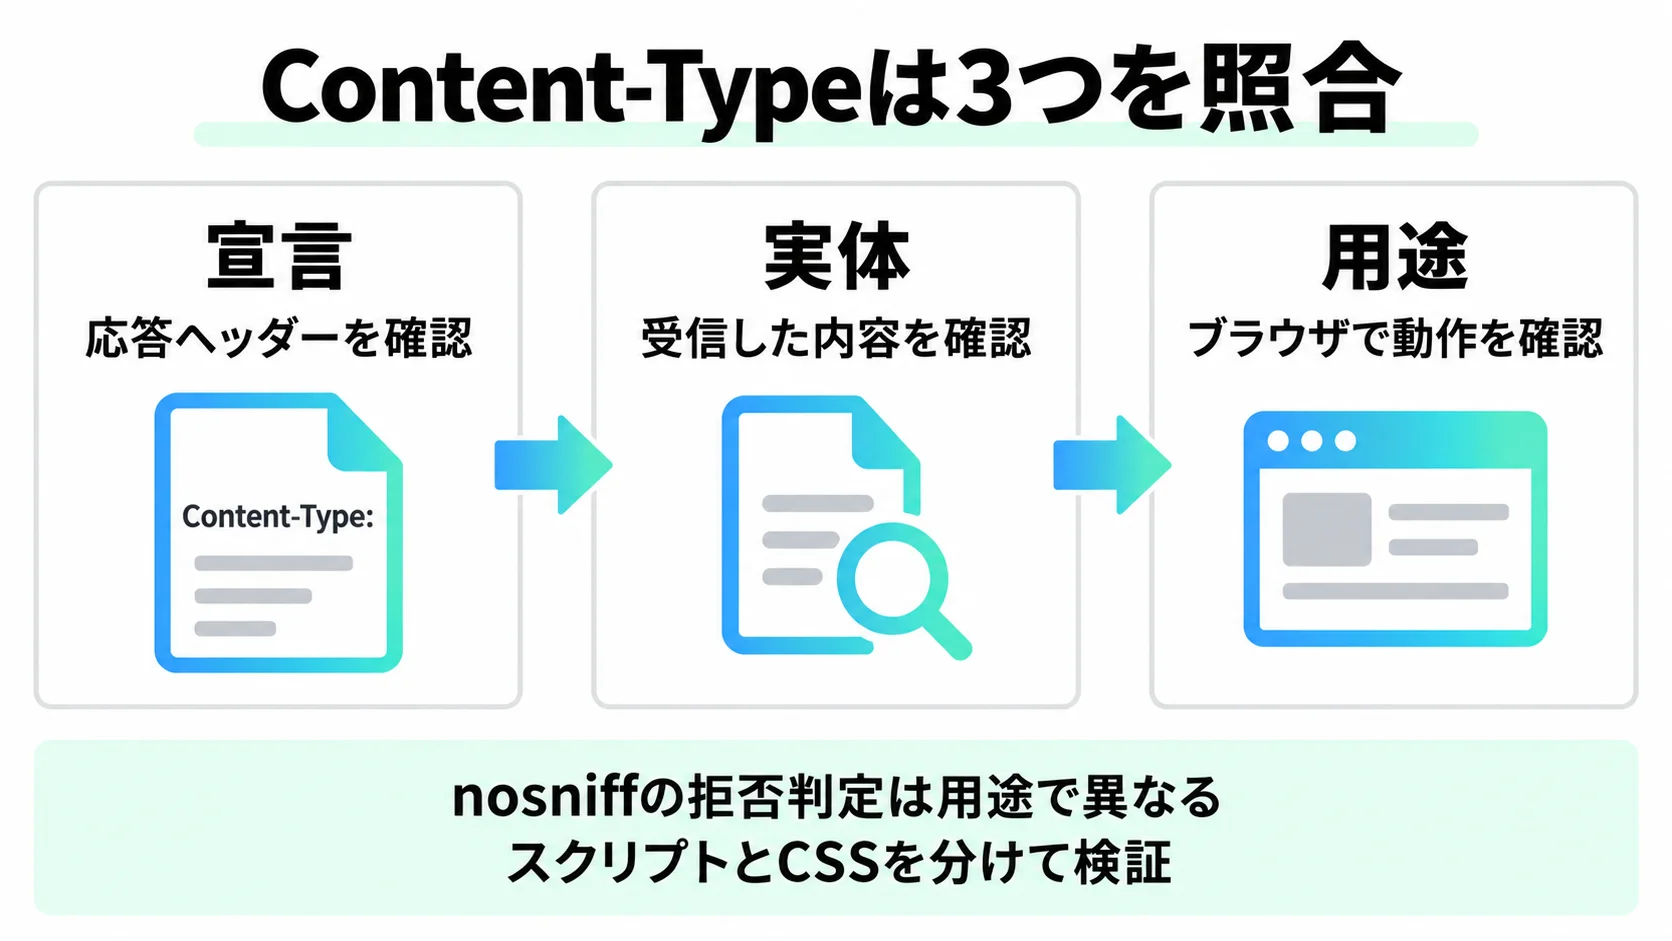
Content-Typeの検証は、レスポンスの宣言、Content-Encodingを復号した後の実体、ブラウザでの用途を同じテストIDで照合します。拡張子を判定の根拠にせず、検証環境の代表URLへGETを行い、ステータス、最終URL、Content-Type、Content-Encoding、本文のサイズとハッシュを保存します。nosniffは、Fetch Standard上ではscript-likeのJavaScript MIME、styleのtext/cssという用途別の条件を満たさない場合に拒否します。画像の表示成否や安全性を、nosniffの拒否判定だけで保証しないでください。
本記事のポイント
- Content-Typeは本文の形式と受信側の処理方法を宣言する値で、拡張子だけではなくヘッダー・復号後の本文・用途を組み合わせて検証します。
- nosniffの拒否判定はscript-likeとstyleで条件が異なり、画像全般を同じアルゴリズムで拒否する保証ではないため、画像は本文形式とブラウザ表示を別に確認します。
- オリジン・CDN・公開URLの応答を同じ条件で比較し、宣言の差、本文の差、キャッシュや配信経路の差を分けて記録します。
1. Content-Typeは宣言であり、本文と用途を合わせて読む
RFC 9110の8.3は、Content-Typeをレスポンスに含まれる表現のメディアタイプを示すヘッダーフィールドと説明しています。メディアタイプはデータ形式だけでなく、受信側がどのように処理することを意図したかも表します。ここでいう処理は、Content-Encodingで示された符号化を復号した後の表現を対象にします。したがって、gzipやBrotliで圧縮された本文をそのままバイト列として調べ、HTMLやJavaScriptではないと結論づけるのは適切ではありません。
同じバイト形式を共有し、意図する処理だけが異なるメディアタイプもあります。RFC 9110が説明するように、データを見ただけでは用途まで区別できない場合があるため、本文のマジックナンバーやパーサーの結果だけを正解にしないことが重要です。たとえばテキストとして読める本文でも、script要素で実行するのか、外部スタイルシートとして読み込むのか、単なるダウンロード対象なのかで、確認すべき条件は変わります。
一方、HTTPで取得するリソースの供給MIMEタイプは、WHATWG MIME Sniffing Standardの定義では、原則としてレスポンスの最後のContent-Typeヘッダーから得られます。ファイル拡張子はHTTPでの供給MIMEタイプを決める根拠に使いません。拡張子は容易に偽装でき、CDN・ストレージ・ルーティング設定の結果を表していないからです。画面に表示された.jsや.cssだけで、配信が正しいとは判定しません。
ダウンロード名や保存方法を確認したいときは、Content-Dispositionと保存名の検証を参照できます。Content-Dispositionは保存や表示の候補名を伝える仕組みで、Content-Typeが表す本文の種類とは役割が違います。二つのヘッダーを同じ「ファイルの設定」として一括りにせず、本文形式と保存名を別の列で記録してください。
| 層 | 見るもの | 合格の考え方 |
|---|---|---|
| 宣言 | HTTPレスポンスのContent-Type、パラメーター、重複の有無 | そのURLが返す表現の意図と、許可したメディアタイプに一致する |
| 実体 | Content-Encodingを復号した本文、署名やマジックナンバー、構文 | 宣言と矛盾せず、期待する形式として解析できる |
| 用途 | script-like、style、image、documentなどのrequest destination | その用途でブラウザが必要とするMIME条件を満たす |
Content-Typeがない場合、受信側がapplication/octet-streamと仮定したり、本文を調べたりする余地があります。しかし、これは配信側が正しい型を返さなくてもよいという意味ではありません。意図した型が分かっている送信側はヘッダーを生成し、受信側が暗黙の推測へ依存しないようにします。
2. 変更前に、宣言・実体・用途の期待値を固定する
検証の最初に、対象URLとリソースの目的を一文で固定します。「検証環境のHTMLがHTMLとして返る」「ログイン画面のCSSがtext/cssとして配信される」「静的画像が正しい本文と画像MIMEで返る」のように、URL・用途・期待する宣言を一組にします。対象を本番URLと混ぜず、ステージングやローカルの検証ホストを明記してください。変更前後で同じURL、同じ認証条件、同じAcceptヘッダーを使えることも記録します。
| 用途 | URL例 | 期待するContent-Type | 本文の確認 |
|---|---|---|---|
| document | /index.html | text/htmlと文字コード | HTMLとして構文解析でき、エラーページでない |
| script-like | /assets/app.js | JavaScript MIMEタイプ(例:text/javascript) | 圧縮を復号した本文が対象ビルドのハッシュと一致する |
| style | /assets/site.css | text/css | CSSとして読み取れ、HTMLの参照先と版が対応する |
| image | /assets/hero.webp | 実際の画像MIME | 画像デコーダーで開け、寸法・ハッシュが期待値と一致する |
| データ取得 | /api/items | 契約したJSONなどの型 | JSON構文、スキーマ、エラー時の本文を分けて確認する |
この表の「実体」は、ファイル拡張子を読み取った結果ではありません。テキストなら構文解析、画像ならデコーダー、JSONならスキーマ検証など、想定する利用方法に沿った検査を選びます。fileやマジックナンバーは異常を見つける補助にはなりますが、RFC 9110が示す「意図した処理方法」まで決めるものではありません。宣言と実体が一致していても、用途の参照先や認証状態が違えば、利用者が受け取る結果は変わります。
重複したContent-Typeも、検証表に独立した項目として残します。RFC 9110はContent-Typeをsingleton fieldとして定義しており、複数回生成されて結合されたような値は誤りです。受信側が最後の構文的に有効な要素を使う実装もありますが、実装ごとのエラー処理が異なると相互運用性と安全性の問題につながります。中継やアプリが同じヘッダーを二重に追加していないか、公開URLで確認してください。
サイト全体のURL、ヘッダー、キャッシュ、担当者を変更管理へ戻す場合は、Webサイトのコンテンツガバナンスで更新責任者・承認・見直し期限を整理できます。Content-Typeの修正は1ファイルの書き換えに見えても、ビルド成果物、配信設定、CDNキャッシュへ影響するため、変更の境界を記録しておくと復旧しやすくなります。
3. 検証環境へのGETでヘッダーと復号後の本文を照合する
確認対象を固定したら、検証環境の公開URLへ実際のGETを行います。HEADは本文を返さないため、本文の実体やエラーページへの置き換えを発見できません。最終リダイレクト先、ステータス、Content-Type、Content-Encoding、Content-Length、ETag、Cache-Controlを同じ記録へ保存し、本文のハッシュを計算します。認証が必要なURLでは、テスト用アカウントと権限を固定し、実データを書き換えるリクエストは使いません。
curl --fail-with-body --compressed -sS \
          -D /tmp/ct-headers.txt \
          -o /tmp/ct-body.bin \
          -w 'status=%{http_code} url=%{url_effective}\n' \
          https://staging.example.test/assets/app.js
        cat /tmp/ct-headers.txt
        shasum -a 256 /tmp/ct-body.bin
file --mime-type /tmp/ct-body.binこのコマンドは検証環境の読み取り用URLを想定した例です。リダイレクトは自動追従しません。3xxの場合はLocationを確認し、遷移先も管理対象であることを確かめてから、そのURLを改めて取得します。認証ヘッダーを第三者ホストへ転送しないよう、経路ごとに取得条件を記録してください。--compressedを使うと、対応するContent-Encodingを展開した本文を保存できますが、ヘッダーのContent-Encoding自体は別に記録します。Content-Lengthが圧縮された転送表現の長さを示す場合、展開後の保存ファイルのバイト数とは一致しません。展開前の保存物と比較する場合は、どの段階のバイト列のハッシュかを明記してください。エンドポイントが圧縮済み本文を返す方式では、オリジンの保存物、CDNの転送表現、クライアントが展開した表現を同じものとして扱わないことが大切です。
ステータスが200でも本文が正しいとは限りません。アプリケーションの404ページを200で返していたり、認証切れのHTMLをJavaScriptのURLへ返していたりする場合があります。本文の先頭だけでなく、構文解析、画像デコード、ビルド時ハッシュ、必要ならスキーマ検証を行い、期待するリソースと同じ版かを確認します。fileの出力とContent-Typeが異なる場合も、すぐにどちらかを正解と決めず、圧縮の有無、本文の取得経路、形式の共有、宣言された用途を調べます。
ブラウザ側ではDevToolsのNetworkで、HTMLが参照したURL、最終レスポンスのヘッダー、実際のステータス、コンソールのMIMEエラーを確認します。JavaScriptやCSSが読み込めないときは、エラーが発生したrequest destinationと、対象レスポンスのContent-Typeを結び付けます。画像は表示できたかだけを合格条件にせず、正しい画像形式、サイズ、ハッシュ、アクセス制御を別欄で確認します。
圧縮や条件付きGETの差も分けて記録します。ETagやLast-Modifiedによる304の世代を調べる場合は、ETag・Last-Modified・304の照合手順のように、ヘッダーの世代と本文の世代を一組で追うと、古いCDN応答をContent-Typeの誤りと取り違えにくくなります。
4. nosniffの拒否判定をscript-likeとstyleで分ける
Fetch StandardのX-Content-Type-Options節は、レスポンスのContent-Typeとリクエストのdestinationを照合するためにnosniffを定義しています。値はnosniffの大文字・小文字を区別しない形で扱われます。運用では中継で値が重複・結合しないよう、単一の正規値を返す設定に揃え、公開URLで確認します。
Fetch Standardの「Should response to request be blocked due to nosniff?」は、まずレスポンスのヘッダーからnosniffを判定します。nosniffでなければこのアルゴリズムはallowedを返します。これは全体の安全性、本文の正しさ、ブラウザのすべての処理が合格したことを意味しません。nosniffが有効な場合は、script-likeのdestinationでMIMEが失敗またはJavaScript MIMEタイプでなければblocked、styleのdestinationでMIMEが失敗またはessenceがtext/cssでなければblockedになります。それ以外はこのアルゴリズムではallowedです。
| 用途 | nosniffの判定 | 別に確認すること |
|---|---|---|
| script-like | JavaScript MIMEでなければ拒否。MIME抽出に失敗しても拒否 | 参照URL、ビルド版、実行時エラー、CSPや権限 |
| style | essenceがtext/cssでなければ拒否。抽出失敗も拒否 | CSS構文、参照先、圧縮後の復号、キャッシュ世代 |
| image | このnosniff拒否アルゴリズムの対象として列挙されない | 画像MIME、デコーダー、本文ハッシュ、表示とアクセス制御 |
| その他 | このアルゴリズムがallowedでも総合合格ではない | 用途固有の仕様、本文形式、認証、CORSなど |
画像について「nosniffなら安全」「画像は必ず拒否されない」と判断することはできません。Fetch Standardの注記は、script-likeまたはstyleだけを考慮しており、imageを含めることは展開されたコンテンツとの互換性がなかったと説明しています。画像は画像のMIMEと実体、ブラウザのデコード、公開範囲を別に検証します。画像のレスポンスがscript-likeとして読み込まれる、あるいは別の用途へ流用される設計なら、そのrequest destinationを調べます。
また、Fetch Standardの2.10には、nosniffとは別の「MIMEタイプによってレスポンスを拒否する」判定があります。script-likeのMIME essenceがaudio/、image/、video/で始まる場合や、text/csvの場合は、この別の判定で拒否されます。したがって、「nosniffがないから必ず実行される」「MIMEが違ってもscriptなら動く」と判断せず、どのアルゴリズムと用途の結果かを記録してください。
検証ケースは、正しいJavaScriptをscript-likeで読み込む、HTMLをJavaScript URLへ返す、正しいCSSをstyleで読み込む、HTMLやJavaScriptをCSS URLへ返す、画像をimageとして読み込む、のように分けます。期待結果には、ヘッダーの宣言、nosniffの有無、request destination、ブラウザの実際のコンソール結果を並べます。仕様上のblockedと、アプリケーションが200のエラーページを返したことを同じ「読み込み失敗」と扱わないことも重要です。
5. オリジン・CDN・ストレージ・ブラウザの差分を切り分ける
Content-Typeの不一致が見つかったら、公開URLだけを直ちに書き換えず、同じ本文をどの経路が返したかを分解します。保存時にオブジェクトへ付けたメタデータ、オリジンのレスポンス、リバースプロキシやCDNのエッジ応答、ブラウザの最終応答を、同じテストID・URL・取得時刻で並べます。中間層がContent-Typeを上書きしているのか、本文の版が古いのか、別のエラー本文に置き換わったのかを順に確認してください。
| オリジン | CDN・公開URL | 疑う範囲 | 次に見るもの |
|---|---|---|---|
| 宣言・本文とも正しい | 宣言だけ違う | CDN、リバースプロキシ、ストレージのMIME上書き | ヘッダー変換、キャッシュキー、配信設定 |
| 本文が正しい | 本文が古い | キャッシュ世代、デプロイ反映、URLの版指定 | ETag、Age、Cache-Control、purge履歴 |
| 宣言が正しい | 本文がHTMLエラー | ルーティング、認証、リダイレクト、フォールバック | 最終URL、ステータス、認証条件、本文ハッシュ |
| 両方が違う | 両方が違う | アップロード、ビルド成果物、デプロイ対象の取り違え | 生成物のハッシュ、公開コミット、ストレージキー |
第三者スクリプトや外部タグが増えたサイトでは、HTMLが参照するscript-likeリソースを先に棚卸しすると、用途と配信元を結び付けやすくなります。Webサイトの第三者スクリプト棚卸しと同じように、URL、所有者、用途、Content-Type、変更責任、廃止条件を台帳へ置きます。外部URLへ同じテストをできない場合は、取得できる応答の範囲と、提供元へ確認する事項を分けて記録してください。
修正後の合格条件は、Content-Typeが期待値になったことだけではありません。対象URLの最終応答が正しいホストから返り、Content-Encodingを復号した本文のハッシュが生成物と一致し、用途ごとのブラウザ検証が通り、CDNキャッシュの世代と変更履歴を説明できることです。検証環境で再現できない状態のまま本番へヘッダーだけを足すと、実体の取り違えや別URLの誤配信を見逃します。
よくある質問
Content-Typeはファイル拡張子から決まりますか?
HTTPで取得するリソースの供給MIMEタイプは、WHATWG MIME Sniffing StandardではレスポンスのContent-Typeヘッダーから決まり、拡張子はその根拠に使われません。拡張子は期待値の手掛かりにはできますが、最終的には公開URLのヘッダー、復号後の本文、ブラウザでの用途を確認します。
Content-Typeが本文と違っても、ブラウザが自動修正すれば問題ありませんか?
問題がないとはいえません。MIMEスニッフィングは互換性のために行われることがありますが、RFC 9110は誤った推測がセキュリティ上のリスクにつながる可能性を説明しています。自動修正に依存せず、宣言と本文を一致させ、用途に必要な条件を満たす配信を作ります。
X-Content-Type-Options: nosniffは画像も拒否しますか?
Fetch Standardのnosniffによる拒否判定は、script-likeとstyleを対象に条件を定めています。script-likeはJavaScript MIMEでないと拒否され、styleはMIMEのessenceがtext/cssでないと拒否されます。画像全般を同じ判定で拒否する保証ではないため、画像はMIME、本文、デコーダー、表示、アクセス制御を別に確認します。
nosniffがないレスポンスは必ず実行されますか?
必ずではありません。nosniffがない場合、Fetch Standardのnosniff判定自体はallowedを返しますが、これは本文の正しさや他のブラウザ処理の合格を意味しません。Fetchにはscript-likeでaudio・image・video MIMEやtext/csvを拒否する別の判定もあるため、request destinationと適用された判定を切り分けます。
Content-Typeヘッダーを2つ返しても、最後の値が使われますか?
最後の値を使う実装があるとしても、複数返す設計を正当化できません。RFC 9110はContent-Typeをsingleton fieldとし、複数値の結合は誤りで、実装差が相互運用性や安全性の問題になると説明しています。アプリ、プロキシ、CDNのどこで重複したかを調べ、単一の正規値に揃えます。
CDNやストレージを含むWeb配信で、MIME宣言と本文の不一致、script・CSSの読み込み失敗、キャッシュ世代の差を一つの検証表へ整理したい場合は、ファネルAiへご相談ください。対象URLと検証環境の条件をもとに、配信経路・実体・用途ごとの確認順を設計します。
公式仕様と一次情報
Content-Typeの意味、Content-Encodingを復号した後の処理、重複ヘッダーの注意はRFC 9110、MIMEタイプの供給値とスニッフィングはWHATWG MIME Sniffing Standard、nosniffの用途別拒否判定はWHATWG Fetch Standardの2026年9月時点の公開仕様を確認しました。
